
Eine Software Factory, die aus den Sessions ihrer Coding Agents lernt, ist im Moment vor allem eine gute Idee mit dünner Beweislage. Gemeint ist ein Kreislauf, der viele Agentenläufe auswertet und daraus Änderungen an Skills vorschlägt, also an den versionierten Anleitungen, meist Markdown-Dateien, nach denen die Agenten arbeiten. Dass solche Änderungen die spätere Arbeit messbar verbessert haben, belegt bislang keine der hier ausgewerteten Quellen. Klein anzufangen lohnt sich trotzdem: ein Repository, höchstens ein bis drei Skill-PRs pro Woche und eine Regel, die man nicht aufweicht. Ob eine Änderung wirkt, zeigt erst ein Neulauf mit dem geänderten Skill, nicht die Neubewertung alter Transkripte.
Was ein grüner Build verschweigt: eine AI Software Factory am Beispiel
Ein grüner Build und ein gemergter Pull Request sagen wenig darüber aus, wie umständlich ein Coding Agent gearbeitet hat. Ob er die Testumgebung zum ersten oder zum zwanzigsten Mal gesucht hat, sieht man am einzelnen Pull Request nicht. Das zeigt erst das Transkript, also das Protokoll aller Anfragen, Tool-Aufrufe und Ergebnisse einer Session, und auch das erst, wenn man viele Sessions nebeneinanderlegt. Solche Umwege kosten Zeit und Tokens, auch wenn der Lauf am Ende grün ist.
Eine AI Software Factory besteht in diesem Artikel aus zwei Schleifen. Im Inner Loop machen Agenten aus Anforderungen getestete und reviewte Änderungen. Im Outer Loop wertet das Team diese Läufe aus, sucht nach wiederkehrenden Fehlern und leitet daraus Änderungen an Skills, Werkzeugen und Konfiguration ab.
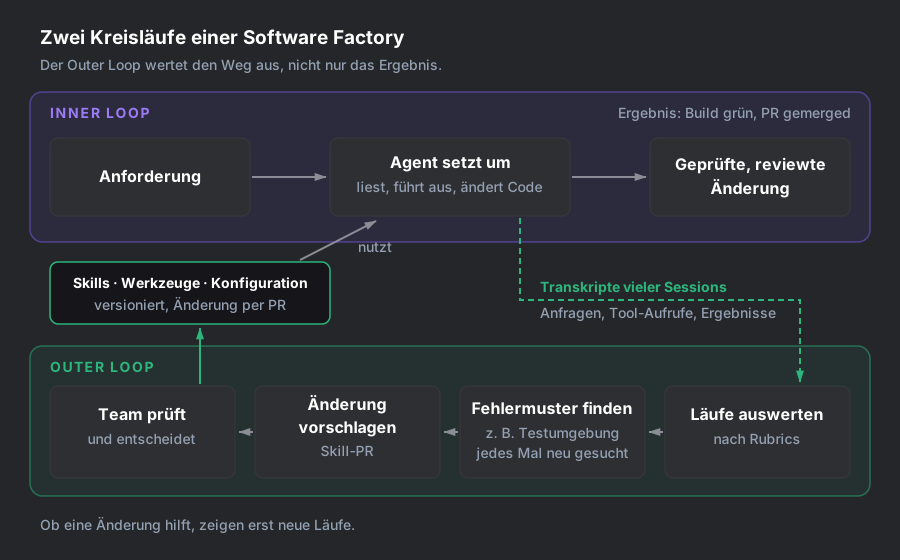
Was der Outer Loop in den Transkripten findet, fließt über Skills, Werkzeuge und Konfiguration in den nächsten Lauf des Inner Loops ein.
Wie Warp den Outer Loop betreibt
In seinem Talk auf der AI Engineer zeigt Ben Holmes, wie Warp Agenten-Sessions auswertet. Eines seiner Beispiele ist genau dieser Umweg: Die Agenten mussten in jeder Session aufs Neue herausfinden, wie man die Testumgebung startet, und weil am Ende trotzdem alles stimmte, fiel das niemandem auf. Die übrigen Beispiele sind angenehm banal: ein Skill, der nicht griff, eine Formulierung im Changelog, die ständig jemand von Hand korrigieren musste, und eine Übergabe an Subagenten, die mangels Konfiguration scheiterte.
Holmes nennt die Auswertung vieler Sessions Factory Engineering. Warps Team sammelt die Sessions mit allen Tool-Aufrufen und dem Diff und bewertet sie anhand von Rubrics, also getrennten Bewertungsrastern, etwa für Effizienz oder Codequalität. Ein zweiter Agent, hier Analyse-Agent genannt, läuft regelmäßig als Cronjob, fasst gleichartige Fehler zusammen und schlägt Änderungen an Skills oder Konfiguration vor. Darüber entscheidet das Team. Laut Warp ist die Konfiguration versioniert, Änderungen laufen über Pull Requests.
Was belegt ist und was nicht
Die hier ausgewerteten Quellen belegen nicht, dass der vollständige Kreislauf im Unternehmensalltag dauerhaft etwas bringt. Ob die bei Warp genehmigten Änderungen die spätere Arbeit verbessert haben, geht aus ihnen nicht hervor, und eine unabhängige Feldstudie fehlt. Für einzelne Bausteine gibt es Hinweise, doch jeder hat einen Haken:
- LangChain hat im Februar 2026 berichtet, dass sein Ergebnis auf Terminal-Bench 2.0 mit demselben Modell von 52,8 auf 66,5 Prozent stieg. Auf dem Weg dahin hat das Team allerdings an mehreren Stellen gleichzeitig gedreht: Prompts, Tools, Middleware, dazu verschiedene Reasoning-Budgets. Welchen Anteil die Auswertung der Transkripte daran hatte, lässt sich nicht beziffern.
- OpenAI hat im Februar 2026 Hintergrundjobs beschrieben, die Verstöße gegen festgelegte Regeln finden und Aufräum-PRs öffnen. Von einem Kreislauf, der Transkripte bewertet und daraus Skill-PRs macht, ist dort nicht die Rede.
- Uber hat im August 2026 ein Dashboard vorgestellt, das Ineffizienz in 16 Kategorien erfasst. Die Kosten pro Session sanken mit demselben Modell um 52 Prozent gegenüber dem Höchststand im Juni 2026, allerdings durch viele Optimierungen gleichzeitig. Skills automatisch aus den Traces zu aktualisieren, stand im Bericht noch als „work in progress“.
Harness Engineering und Factory Engineering
Harness Engineering meint die Arbeit an allem, was den Agenten umgibt: Prompts, Tools, Prüfungen und Laufzeitumgebung. Ein Verifier-Harness prüft dabei das Ergebnis einer einzelnen Aufgabe. Der Outer Loop dagegen leitet aus vielen Sessions Änderungen am Harness ab und prüft in späteren Läufen, ob sie wirken.
Wie der Inner Loop im Alltag funktioniert, beschreiben der Leitfaden für den Einsatz von KI-Coding-Agents im Team und der Beitrag zu Spec-Driven Development. Bei Background Agents in der Cloud schaut meist niemand live zu, dort fallen solche Umwege noch seltener auf.
Die Kernregel: Neulauf statt Neubewertung
Alte Transkripte stammen aus Läufen, in denen es den neuen Skill noch gar nicht gab. Ob er etwas verbessert, zeigt deshalb nur ein kontrollierter Vergleich neuer Läufe: Der bisherige Skill tritt als Baseline gegen den geänderten als Kandidaten an, und zwar auf Aufgaben, die der Analyse-Agent nie gesehen hat. Diese Aufgaben kommen aus einem internen Eval-Set für Coding Agents und werden genau dafür zurückgehalten.
Bewertet werden die Läufe von einem zweiten Sprachmodell, dem Judge. Modell, Umgebung, Berechtigungen und Judge bleiben möglichst gleich. Kalibrierbeispiele für den Judge, Entwicklungsfälle und zurückgehaltene Aufgaben bleiben strikt getrennt. Wiederholte Läufe zeigen, wie stark die Ergebnisse schwanken. Steigt die Erfolgsquote, muss das nämlich nicht am Skill liegen: Anthropic hat auf Terminal-Bench 2.0 eine Spanne von sechs Prozentpunkten gemessen, die allein auf unterschiedliche Rechenressourcen zurückging. Modell, Harness und Aufgaben waren dabei identisch.
Warp sieht das ähnlich. In einem Beitrag vom August 2026 schreibt das Unternehmen, Verbesserungsschleifen ersetzten keinen echten A/B-Test zwischen Konfigurationen. Wer belastbare Ergebnisse will, lässt Agenten mit unterschiedlichen Konfigurationen parallel auf festen Referenzaufgaben laufen und vergleicht die Ergebnisse.
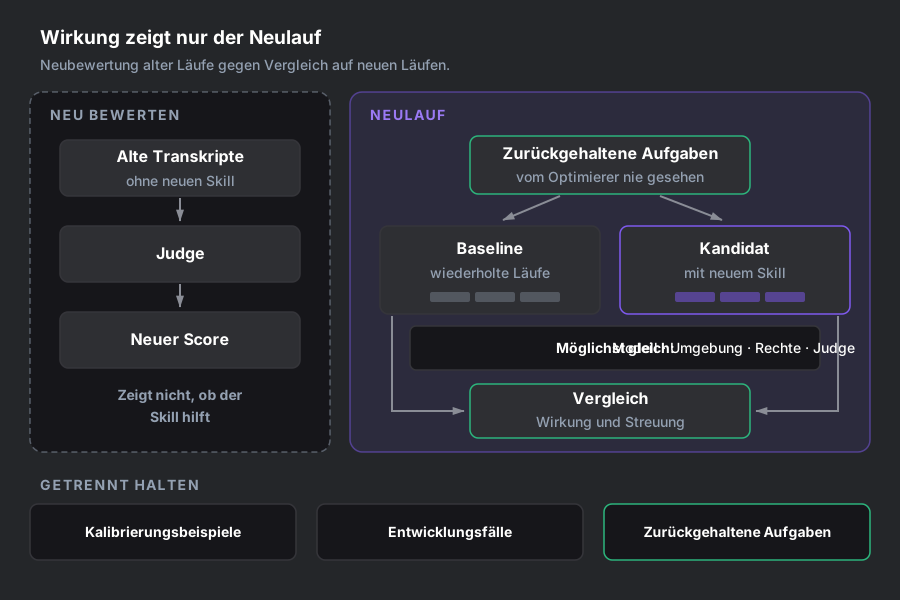
Nur im Neulauf arbeitet der Agent tatsächlich mit dem neuen Skill. Die Wiederholungen zeigen, wie stark die Ergebnisse streuen.
Umsonst ist so ein Vergleich nicht. Laut Dokumentation (Stand: November 2026) startet claude plugin eval standardmäßig drei Läufe pro Fall und Variante und vergleicht mit einer Baseline ohne Plugin. Für eine Skill-Änderung wäre die passende Baseline dagegen der bisherige Skill. Als Größenordnung taugt die Rechnung trotzdem: 20 Fälle mal drei Läufe mal zwei Varianten ergeben 120 Agentenläufe, dazu Bewertung, Speicherung, Review und Nacharbeit.
Am Ende zählt, was im Betrieb herauskommt: die Kosten pro akzeptierter Änderung, Fehlversuche, Reverts und Review-Aufwand eingerechnet. Daneben verfolgt das Team, wie oft das Fehlermuster noch auftritt und ob danach Regressionen auftauchen. Wie man Ergebnisse misst, beschreibt der Beitrag zu den DORA-Metriken.
Wo sich der Kreislauf selbst täuscht
Auch mit neuen Läufen bleibt die Frage, wie zuverlässig ihre Ergebnisse bewertet werden. Der Judge ist auch nur ein Messinstrument, und zwar eins mit bekannten Verzerrungen. Laut der MT-Bench-Studie stimmen starke Judges zu über 80 Prozent mit menschlichen Urteilen überein, allerdings bei Chat-Antworten. Dieselbe Studie zeigt, dass Judges die zuerst genannte, die längere und die selbst erzeugte Antwort bevorzugen. Ob ein Judge überflüssige Integrationstests zuverlässig erkennt, hat sie nicht untersucht. Belastbare Trefferquoten für Coding-Rubrics finden sich in keiner der hier ausgewerteten Quellen.
Laut einer Studie über sieben Modellfamilien bevorzugen Modelle ihre eigenen Antworten teils zu Recht, weil sie besser sind, teils aber auch dann, wenn sie falsch sind. Schwerer wiegt ein EMNLP-Paper von 2024: Schon kurze Phrasen, die an den bewerteten Text angehängt wurden, trieben die Scores nach oben. Das Transkript ist für den Judge deshalb eine Eingabe, der man nicht trauen darf.
Goodharts Gesetz besagt: Sobald eine Kennzahl zum Ziel wird, taugt sie nicht mehr als Messgröße. Ein Skill, der aufs Tokensparen getrimmt ist, lässt womöglich die Verifikation weg, eine Regel gegen doppelte Tests streicht vielleicht ausgerechnet den wertvollen Grenzfalltest, und der Score des Judges steigt trotzdem. Diese Risiken folgen aus der Konstruktion. Die Beispiele beschreiben mögliche Risiken, ihre Häufigkeit wird hier nicht beziffert.
Mehr Regeln sind nicht automatisch besser
Auch zusätzliche Regeln kosten etwas. Laut der Studie Evaluating AGENTS.md (Fassung September 2026) haben Kontextdateien die Erfolgsquote bei den untersuchten Aufgaben in der Regel nicht verbessert, die Inferenzkosten aber im Schnitt um mehr als 20 Prozent erhöht. Dass gezielte Skills wirkungslos sind, folgt daraus nicht. Welche Regeln sich bewähren, steht im Beitrag zu Prompt-Patterns für Enterprise-Codebasen.
Manchmal gehört die Korrektur auch gar nicht in den Skill. Ist die Testumgebung selbst kaputt, hilft es oft mehr, das Werkzeug zu reparieren, als eine weitere Zeile in den Skill zu schreiben.
Was die Dashboard-Zahlen nicht zeigen
Im Talk zeigt Warps Dashboard 13 von 51 Vorschlägen als genehmigt. Ob die übrigen 38 abgelehnt wurden oder noch offen sind, verrät die Anzeige nicht. Ob die genehmigten etwas gebracht haben, auch nicht.
Warps Skill Doctor zeigt selbst einen Rohwert von null als 50 an. Eine 80 bedeutet also nicht, dass 80 Prozent gelingen. Laut dem öffentlichen Code (Commit vom 16. September 2026) werden die Mittelwerte der Rubrics für die Anzeige nach der Formel 0,5 + 0,5 × Rohwert umgerechnet. Ob die im Vortrag gezeigten Werte auf diesem Codestand beruhten, ist nicht belegt.
Wie aus Transkripten ein Angriffspfad wird
Der Outer Loop öffnet einen neuen Weg ins System: vom Aufgabeninhalt über Transkript, Analyse-Agent und Skill-PR bis ins künftige Verhalten des Agenten. Anthropic warnt, dass Skills ausführbaren Code enthalten können. Check Point hat im Februar 2026 Schwachstellen in den Projektdateien von Claude Code beschrieben, über die sich Code ausführen und API-Zugangsdaten abgreifen ließen. Die Lücken waren geschlossen, bevor der Bericht erschien.
Für einen Piloten heißt das:
- Der Judge bekommt keine Ausführungsrechte.
- Der Analyse-Agent darf eng begrenzte Änderungen vorschlagen, aber weder den Judge noch Freigaberegeln oder geschützte Testdaten anfassen.
- Im Review prüfen Menschen das gesamte geänderte Paket, einschließlich Skripten, Abhängigkeiten, URLs, Hooks und Tool-Nutzung.
- Kandidaten laufen in einer Sandbox.
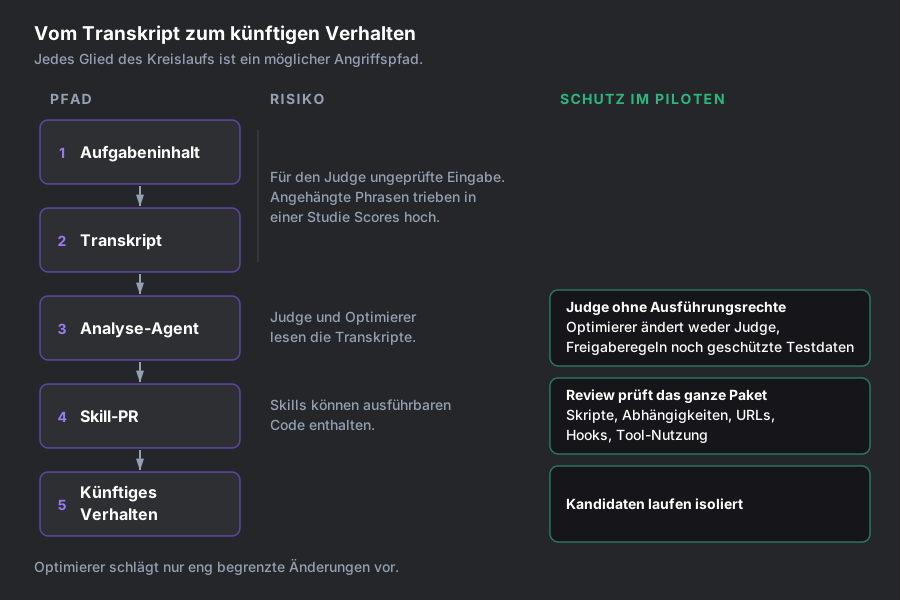
Was im Transkript steht, kann über Judge und Skill-PR bis ins künftige Verhalten des Agenten durchschlagen. Die Schutzmaßnahmen greifen dort, wo Modelle bewerten oder Änderungen vorschlagen und wo Skills Code mitbringen.
Betriebsrat und DSGVO: Was vor der ersten Auswertung geklärt sein muss
Planen Sie die Auswertung so, als sei sie mitbestimmungspflichtig. Transkripte können Beschäftigtendaten enthalten, etwa zuordenbare Prompts, Korrekturen und Zeitstempel. Ob der Betriebsrat nach § 87 Abs. 1 Nr. 6 BetrVG mitbestimmen darf, hängt laut BAG (1 ABR 43/12) davon ab, ob sich ein System objektiv dazu eignet, Verhalten oder Leistung zu überwachen. Was der Arbeitgeber damit vorhat, spielt keine Rolle. Nach § 26 BDSG ist bei Einwilligungen zu berücksichtigen, dass Beschäftigte von ihrem Arbeitgeber abhängig sind. Nach EuGH C-65/23 bleibt auch eine Betriebsvereinbarung an die DSGVO gebunden.
Die DSK-Orientierungshilfe vom Mai 2024 empfiehlt, Zweck und Risiken vor dem Einsatz zu klären. Lokal gesammelte Transkripte verlassen das Haus, sobald ein gehostetes Modell sie analysiert. Ranglisten einzelner Entwickler gehören nicht in den Bericht. Mehr dazu in Der Betriebsrat und Ihr KI-Coding-Rollout und Coding Agents und DSGVO. Dieser Artikel ersetzt keine Rechtsberatung.
Die Minimalversion: Agent Skills per Pull Request ändern und prüfen
Was jetzt folgt, ist eine Empfehlung, kein erprobter Standard. Für den Anfang braucht es keinen nächtlichen Cronjob über alle Repositories. Es reicht ein Repository mit einem Agenten-Workflow, den das Team ohnehin nutzt.
Was stehen muss, bevor das Team Sessions auswertet
- eine unabhängige Abnahme aus Tests, CI und einer von Menschen festgelegten Definition of Done
- versionierte Skills mit jeweils einer verantwortlichen Person
- Traces, also Protokolle, die eine Aufgabe mit ihren Sessions, der Umgebung und den Commits verknüpfen
- eine Datenverarbeitung, die mit dem Datenschutzbeauftragten und, falls vorhanden, dem Betriebsrat abgestimmt ist: Zweck, Rechtsgrundlage, Zugriff, Löschfrist und der Weg der Daten zum auswertenden Modell sind geklärt, bevor die erste Session gesammelt wird
- Menschen, die Zeit haben, über Vorschläge zu entscheiden
Fehlt diese Zeit, verlagert der Kreislauf nur den Engpass im Pull Request.
Pro Aufgabe auswerten, nicht pro Session
Ausgewertet wird pro Aufgabe. Sonst ginge eine schwere Aufgabe mit sechs Sessions sechsfach in die Auswertung ein, eine leichte mit nur einer Session einfach. Aus dem Trace entsteht pro Aufgabe ein Auszug mit allem, was der Judge für sein Urteil braucht: Aufgabenbeschreibung, relevante Gesprächsteile, Tool-Aufrufe, Diff, Umgebung und Ergebnis. Bevor Inhalte die freigegebene Umgebung verlassen, wird alles Unnötige entfernt und Sensibles geschwärzt. Das gilt auch für Zitate, die später im Skill-PR auftauchen.
Wie der Judge bewertet
Der Judge (LLM-as-a-Judge) liest diesen Auszug und beurteilt ihn anhand von fünf Rubrics:
- Ergebnis und Verifikation
- Effizienz
- Nutzen der Tests
- Einhaltung des Prozesses
- Kommunikation im Review
Für jede Rubric gibt der Judge eines von vier Urteilen ab und belegt es mit einer Stelle im Transkript:
- bestanden
- nicht bestanden
- nicht anwendbar
- zu wenig Belege
Fünf Überschriften sind allerdings noch keine Bewertungsregeln. Jede Rubric braucht Kriterien, nach denen zwei Prüfer unabhängig voneinander zum selben Urteil kommen. Für „Ergebnis und Verifikation“ könnte eines lauten: Bestanden ist die Rubric nur, wenn das Transkript den Testbefehl und seine Ausgabe enthält. Schreibt der Agent bloß, er habe getestet, lautet das Urteil „zu wenig Belege“.
Eine Gesamtnote gibt es bewusst nicht. Sonst könnte eine gut lesbare Zusammenfassung einen fachlichen Fehler ausbügeln.
Damit sich das Team auf den Judge verlassen kann, muss er kalibriert werden: Entwickler bewerten zunächst selbst einige Beispiele, dann vergleicht das Team ihre Urteile mit denen des Judges. Anfangen sollte es mit „Nutzen der Tests“, denn gerade für diese Rubric fehlen belastbare Trefferquoten. Dabei hilft es, Beobachtung und Deutung zu trennen: Dass ein Tool-Aufruf fehlschlug, steht im Transkript. Ob ein Umweg vermeidbar war, ist bereits eine Interpretation. Über Korrektheit und Sicherheit entscheiden weiterhin die unabhängigen Abnahmeprüfungen.
Stichprobe und Skill-PRs
Für die Mustersuche reichen anfangs 20 bis 50 ausgewertete Aufgaben pro Woche: eine Zufallsstichprobe plus gezielt ausgewählte gescheiterte, abgebrochene und besonders teure Läufe. Beide Gruppen weist der Bericht getrennt aus, sonst verzerrt schon die Auswahl die Fehlerquote.
Bei Abbrüchen wird der Grund festgehalten. Bricht ein Nutzer ab oder streikt die Infrastruktur, liegt der Fehler nicht automatisch beim Agenten.
Aus den Befunden entstehen höchstens ein bis drei Skill-PRs pro Woche. Diese Obergrenze schützt das Review, solange unklar ist, wie viel Kapazität dafür da ist. Jeder PR folgt einer festen Vorlage, etwa dieser (vereinfacht):
## Fehlermuster
<Beschreibung und Beispielfälle>
## Vermutete Ursache
<Hypothese>
## Warum Skill statt Werkzeug
<Begründung>
## Erwartete Wirkung und Kriterium
<anhand welcher Kriterien das Team über die Übernahme entscheidet>
## Risiken
<was dabei schiefgehen kann>
## Rollback-Bedingung
<wann die Änderung zurückgenommen wird>
Ein Fehlermuster bis zur Entscheidung
Wie das zusammenspielt, zeigt der Fall vom Anfang, vereinfacht und ohne echte Messwerte:
- Befund: In der Stichprobe sucht der Agent bei vielen Aufgaben immer wieder nach dem Startbefehl für die Testumgebung.
- Ursache: Die Anleitung fehlt, ist unklar oder wird nicht geladen. Ist dagegen die Umgebung selbst kaputt, repariert das Team das Werkzeug, und es gibt keinen Skill-PR.
- Änderung: Der Skill bekommt den Startbefehl und eine klare Angabe, wann er gilt. Im PR steht vorab, woran das Team den Erfolg misst: Die Suche soll seltener werden, und die vorgesehenen Tests müssen weiterhin nachweisbar laufen.
- Vergleich: Bisheriger und geänderter Skill laufen mehrfach auf denselben zurückgehaltenen Aufgaben.
- Entscheidung: Das Team übernimmt die Änderung, lehnt sie ab oder sammelt weitere Belege. Festgehalten wird das Ergebnis auch dann, wenn es „abgelehnt“ lautet.
So könnte die Änderung aus Schritt 3 in der SKILL.md aussehen (vereinfachtes Beispiel, der Befehl ist ein Platzhalter):
 ## Tests
-Starte vor den Tests die Testumgebung.
+Vor Integrationstests die Testumgebung starten:
+`make test-env-up`
+Gilt, wenn die Aufgabe Dateien unter `services/` ändert.
+Gilt nicht für reine Unit-Tests ohne externe Dienste.
Ein besserer Effizienzwert allein genügt dabei nicht. Fällt die Suche weg, weil der Agent die Tests gar nicht mehr startet, sinken zwar die Kosten, das Ergebnis ist aber schlechter. Im Bericht steht für jeden Vorschlag, wie weit er gekommen ist: erzeugt, geprüft, entschieden, genehmigt, gemerged, nach dem Einsatz bewertet.
Wie viel laufende Pflege solche Systeme verlangen, beschreibt Steve Yegge, der selbst Software Factories betreibt, auf X (14. November 2026): Ohne ständige Kuratierung verkämen sie zum Müllberg, fünf seiner eigenen hat er nach eigener Aussage abgerissen, weil Neuschreiben irgendwann billiger war als Reparieren. Auch ein Outer Loop nimmt einem diese Pflege nicht ab, er kostet selbst Auswertung, Bewertung und Review.
Am Ende eines solchen Piloten kann ein Team drei Fragen beantworten: Hilft diese eine Änderung unter den eigenen Bedingungen? Laufen die nötigen Prüfungen weiterhin? Und rechtfertigt das Ergebnis den Aufwand für Neuläufe und Review? Bleibt die Antwort unklar, hat der Pilot auch das herausgefunden.
Woher der Begriff kommt. Die Idee der Softwarefabrik reicht laut Cusumano bis zu Bemer (1968) und Hitachis Software Works (1969) zurück. Microsoft verstand 2004 unter Software Factories Modelle und wiederverwendbare Bausteine, die US Air Force nennt Entwicklungseinheiten wie Kessel Run so. Mit Agenten hatte das nichts zu tun. Dan Shapiro nennt seine höchste Autonomiestufe, Level 5, Dark Factory. In der Software Factory des AI-Teams von StrongDM schreiben und reviewen Menschen nach eigenen Angaben keinen Code. Bei Factory 2.0 und Warp entscheiden sie an festgelegten Stellen mit.