
Agentencode sichern Teams bisher meist mit Tests und Review ab. Inzwischen schreiben Coding Agents auch maschinell geprüfte Beweise in Lean, Rocq, Dafny oder Verus und TLA+-Modelle für den Model Checker. Das ändert, wer im Team was prüfen muss.
391 Zeilen cJSON, 630.000 Zeilen Beweis
Der Einstiegspunkt des cJSON-Parsers hat 391 Zeilen. Der Beweis, dass er nicht abstürzt, hat laut Anhang von Anthropic rund 630.000 Zeilen Rocq, und nur etwa ein Zehntel davon betrifft cJSON selbst. Geschrieben hat ihn Claude. Im gesamten Projekt waren die Spezifikationen der Agenten im Median rund 110 Zeilen lang. Die Programmgröße lag im Median bei 86 KB.
Der Anlass: Das Frontier Red Team von Anthropic meldet zusammen mit Theorem No-Crash-Beweise für 239 Entry Points in 123 Bibliotheken. Die bewiesene Eigenschaft ist eng gefasst: keine Abstürze bei Eingaben bis 64 MB, für single-threaded, statisch gelinkte RISC-V-Binaries mit musl. Stand 1. November 2026 lassen sich 61 Entry Points in 26 Bibliotheken öffentlich nachprüfen, im Repository oss-verify-proofs.
Für die Frage, wie Teams Agentenarbeit absichern, heißt das: Der Prüfaufwand verschiebt sich. Die 630.000 Zeilen liest niemand, die prüft der Rocq-Kernel. Ein Mensch muss beurteilen, ob die Spezifikation (im Projektmedian rund 110 Zeilen) die gewünschte Eigenschaft beschreibt und ob ihre Annahmen zum eingesetzten System passen.
Die Zahlen stammen vom Hersteller und veranschaulichen nur die Größenordnung. Offen bleibt, was davon für ein Enterprise-Team gilt, das keine Rocq-Spezialisten beschäftigt und für sein eigenes Fehlerbild keine fertige Spezifikation hat.
Was formale Verifikation ist und welche Arbeit Agenten übernehmen
Formale Verifikation, englisch Formal Verification, heißt, mathematisch zu beweisen, dass Software ihre Spezifikation erfüllt. Ein Test prüft einzelne Eingaben. Ein Beweis gilt für alle Fälle, die die Spezifikation beschreibt, aber eben nur „with respect to its specification“ und auf der Abstraktionsebene, auf der sie formuliert ist (ter Beek et al., Formal Aspects of Computing).
Edsger Dijkstra hat den Unterschied schon 1970 auf einen Satz gebracht: „Program testing can be used to show the presence of bugs, but never to show their absence!“ (EWD249). Diese Lücke schließt nur ein Beweis.
Zwischen den beiden Polen liegt eine pragmatische Mitte. Daniel Jackson schlug 1996 „lightweight formal methods“ vor, also formale Mittel nur teilweise einzusetzen: „it makes more sense to sacrifice the ability to find proofs than the ability to detect errors reliably“ (Jackson).
Amazon hat genau das bei S3 ShardStore gemacht. Das Team nutzte Property-Based Testing und Model Checking mit ausführbaren Referenzmodellen und fing so 16 Fehler vor dem Produktiveinsatz ab. Schwächere Garantien als bei voller Verifikation nahm es bewusst in Kauf (Bornholt et al., SOSP 2021).
Die Spec im Spec-Driven Development ist Prosa, die den Agenten steuert. Hier ist die formale Spezifikation gemeint. Sie beschreibt gewünschte Eigenschaften mathematisch, etwa als Vor- und Nachbedingungen, als Theorem oder als Invarianten eines Modells. Der Nachweis bezieht sich nur auf diese Eigenschaften.
Bisher scheiterten formale Methoden meist am Aufwand. Bei seL4 kamen auf 8.700 Zeilen C insgesamt rund 200.000 Zeilen Isabelle, einschließlich Framework, Bibliotheken und generierter Beweise. Der Aufwand lag bei rund 20 Personenjahren, davon 11 speziell für seL4 (Klein et al., SOSP 2009).
Bei Microsofts SymCrypt ist das Verhältnis 2026 kaum kleiner: 237 KLOC Lean belegen die Korrektheit von 16,7 KLOC Rust. Nur schreiben die Beweise dort inzwischen Agenten, und zwar selbständig (Ho et al.). Die Formalisierung der Standards „still requires expert design and review“.
In Microsofts Fallstudien „Proofs Promptly“ erledigten drei Experten die Arbeit in zwei Wochen. Den Aufwand für manuelle Beweisentwicklung schätzen die Autoren auf etwa ein halbes Jahr (Ioannidis, Swamy et al.). Im zlib-Projekt, das Kim Morrison durchführte, schrieb Claude ohne Spezialtraining die Beweise. Das Abschlusstheorem zlib_decompressSingle_compress gilt allerdings nur für Daten unter 1 GiB (de Moura).
Dass formale Verifikation mit KI überhaupt funktioniert, begründet Martin Kleppmann mit dem Checker: „It doesn't matter if they hallucinate nonsense, because the proof checker will reject any invalid proof“ (Kleppmann). Das stimmt, solange der Checker selbst korrekt ist. 2026 war er das mehrfach nicht, dazu unten mehr.
Formal Verification gegen Testing: fünf Stufen bis zum Beweisassistenten
Anthropic hat in einem Nebenexperiment einen Python-Interpreter in Rust mit Verus verifiziert und dabei sieben Bugs absichtlich eingebaut. Laut Appendix rutschten fünf davon durch die Zufallstests, an allen sieben scheiterte der Beweis.
Anthropic schreibt allerdings selbst: „'Formally verified' does not mean 'bug-free.'“ Der Proof Checker kann nicht sagen, ob die Spezifikation zur Realität passt. Zwischen Zufallstest und Beweis liegen mehrere Stufen. Sie prüfen Unterschiedliches, von Stichproben über begrenzte Zustandsräume bis zum Kernel-geprüften Beweis, und auf jeder verteilt sich die Arbeit zwischen Agent und Mensch anders. Die Zahlen in der letzten Spalte stammen aus unterschiedlichen Versuchsaufbauten und messen Verschiedenes, von validen Bug-Reports über bestätigte Fehler bis zu gelösten Beweisaufgaben. Als Rangliste taugen sie nicht.
| Stufe | Werkzeug | Was der Agent übernimmt | Was der Mensch liefert | Garantie | Ergebnis im jeweiligen Versuch |
|---|---|---|---|---|---|
| Property-Based Testing | Hypothesis | Properties, Generatoren, Bug-Reports | Triage der Reports | Stichprobe, kein Beweis | 56 % valide Reports |
| Bounded Model Checking | Kani | Harnesses | Auswahl der Funktionen, Contracts | alle Eingaben bis zur Unwinding-Grenze | HarnessLLM (Sept. 2026): Harnesses für 294 Szenarien, sechs Memory-Safety-Bugs in pdf-rs 0.9.0 |
| Model Checking | TLA+ | Spec, Invarianten | Systemidee, fehlende Invarianten | alle Zustände im geprüften Modell | 68 von 89 gemeldeten Bugs bestätigt |
| Deduktive Verifikation | Dafny, Verus | Invarianten, Lemmas, Beweis | Spezifikation | alle Eingaben, relativ zur Spec | 89 % Dafny (Vericoding, Sept. 2025), 81 % Verus (VeruSAGE, Apr. 2026) |
| Beweisassistent | Lean, Rocq | Beweis | Spezifikation, Theorem-Statement | Kernel-geprüft, relativ zur Spec | Vericoding (Sept. 2025), Lean: bestes Einzelmodell GPT-5 17,9 %, Vereinigung über neun Modelle 27 % |
Im Sinne des Verifier-Harness-Artikels liefern alle fünf Stufen ein Orakel, das sich nicht überreden lässt, aber unterschiedlich viel nachweist. Ob die geprüften Aussagen die richtigen sind und ob die Prüfkette selbst hält, beantwortet keine der Stufen.
Property-Based Testing mit Agenten
Beim Property-Based Testing beschreibt man eine Eigenschaft („Sortieren ändert die Länge nicht“), und das Framework erzeugt dazu Hunderte Eingaben. In einer Studie zu Agentic PBT vom Oktober 2025 ließ man Claude Code mit Opus 4.1 und Hypothesis auf 100 Python-Pakete los. Heraus kamen 984 Bug-Reports, davon 56 % valide, bei 5,56 Dollar pro Report. Fast jeder zweite Report ist also Rauschen, das ein Mensch aussortieren muss.
Wer wissen will, ob die erzeugten Tests überhaupt etwas finden würden, prüft sie mit Mutation Testing. Mehr dazu steht in den Mustern zur Testgenerierung mit Coding Agents.
Bounded Model Checking für Rust
Kani prüft Rust-Code symbolisch: Ein Harness legt fest, welche Eingaben beliebig sein dürfen, und Kani rechnet alle Pfade durch, aber nur bis zur gesetzten Unwinding-Grenze für Schleifen. Für Rust-Teams ist das ein möglicher Einstieg über einzelne Funktionen. Wie leicht er ohne Erfahrung mit formalen Methoden gelingt, belegen die hier vorgestellten Studien nicht.
HarnessLLM erzeugt solche Harnesses mit einem Sprachmodell. Für alle 294 Szenarien aus neun crates.io-Codebasen entstanden Harnesses in rund 145 Sekunden je Szenario. Dabei fanden sich sechs echte Memory-Safety-Bugs, alle in pdf-rs 0.9.0.
Das deterministische Kani Autoharness ohne Sprachmodell schaffte 41 % der HarnessLLM-Szenarien. Bei der Verifikation der Rust-Standardbibliothek erzeugte Autoharness, ebenfalls ohne Sprachmodell, 16.748 Harnesses. Stand März 2026 bestanden 11.970 davon die Prüfung „against Kani's supported classes of UB“. Gegen formale Contracts verifiziert waren nur 989 Funktionen. Von Hand waren in sechzehn Monaten 725 Harnesses entstanden.
Model Checking mit TLA+
TLA+ beschreibt ein System als Zustandsmaschine. Der Model Checker durchläuft dann jeden erreichbaren Zustand des Modells. Cheng Huang von Microsoft Azure Storage ließ Agenten eine TLA+-Spec mit über zehn Invarianten schreiben. Innerhalb von Stunden fand der Model Checker eine Race Condition: Ein alter Paxos-Primary konnte löschen, während ein neuer gleichzeitig eine Referenz hinzufügte. Die Concurrency Control über Etags hatten Menschen nachträglich ergänzen lassen.
Datadog arbeitet „harness-first“. Aus ADRs werden TLA+-Specs, und deren Invarianten tauchen in Stateright, deterministischer Simulation, Kani und Telemetrie wieder auf. Den Denkaufwand für Specs und Invarianten, den „mental overhead“, schätzt Datadog auf etwa das Doppelte bis Dreifache des Aufwands für den Code selbst. Gemessen hat Datadog das nicht, es ist die Einschätzung des Teams.
Specula verbindet TLA+ mit Trace Validation am echten Code. Jeder gefundene Bug wird auf Code-Ebene reproduziert. Von 89 gemeldeten Bugs hatten Entwickler bis Juli 2026 laut den Autoren 68 bestätigt.
Deduktive Verifikation mit Dafny und Verus
Dafny und Verus (für Rust) übergeben Vor- und Nachbedingungen an einen SMT-Solver, ein Programm, das logische Formeln automatisch entscheidet. Der Agent muss nur Schleifeninvarianten und Hilfslemmas liefern, bis der Solver zustimmt. Bei vorgegebener Spec und vorgegebenem Code löst Opus 4.1 im Vericoding-Benchmark vom September 2025 89 % der Dafny-Aufgaben.
Muss der Agent auch den Code schreiben, meldet Vericoding 82 % für Dafny. Das ist allerdings die Vereinigung über mehrere Modelle. Das beste Einzelmodell, Claude Opus 4.1, erreicht 67,5 %.
VeruSAGE testet in der Fassung vom April 2026 Verus an 849 Aufgaben aus acht verifizierten Rust-Systemen aus der Praxis. Sonnet 4.5 schafft dort 81 %.
Lean Theorem Prover und Rocq
In Lean und Rocq schreibt der Agent den Beweis Schritt für Schritt, und ein kleiner Kernel prüft jeden Schritt. Rocq ist das umbenannte Coq, die Umbenennung war mit Rocq 9.0 im März 2025 abgeschlossen. SymCrypt und zlib, beide oben erwähnt, sind Lean-Projekte. Bei zlib steckt die Annahme in der Vorbedingung des Abschlusstheorems: Daten unter 1 GiB.
Agenten bekommen ihre Werkzeuge über lean-lsp-mcp, Stand 1. November 2026 in Version 0.32.0. Der MCP-Server liefert unter anderem Beweisziele und Diagnosen. lean_verify listet die verwendeten Axiome und scannt optional nach Mustern wie unsafe oder set_option debug.*. Für Dafny, Verus und Kani ist Stand 1. November 2026 kein offizieller MCP-Server bekannt, nur Community-Projekte wie dafny-mcp.
Der Engpass wandert zur Spezifikation
Die Beweisquoten aus Vericoding und VeruSAGE gelten für Aufgaben mit vorgegebener Spezifikation. Wie gut ein Agent die passende Spezifikation selbst findet, sagen sie nicht. Diese Hürde untersucht der Benchmark CLEVER in einem anderen Versuchsaufbau. Dort muss das Modell alles allein erledigen: eine Spezifikation finden, ihre Gleichwertigkeit mit der Referenz beweisen, den Code schreiben und beweisen, dass er die Spezifikation erfüllt. End-to-End gelingt das bei „up to 1/161“ Aufgaben. 71 bis 90 % der Spec-Entwürfe kompilieren. Der Äquivalenzbeweis gelingt nur bei 0 bis 1,9 % (Stand Herbst 2025, Modelle der Claude-3.7-Ära). Das ist ein Strukturbefund über die Spezifikationsstufe, keine aktuelle Leistungsgrenze für Coding Agents.
In SysMoBench ließen die Autoren im Mai 2026 elf Modelle TLA+-Spezifikationen für elf Systeme schreiben. Die Syntax stimmte fast immer, die Übereinstimmung mit dem echten System lag im Schnitt bei rund 46 %. Zum etcd-Raft-Modell schreiben die Autoren, es „looks like the spec from the Raft paper, and it has very little to do with Etcd-specific details.“ Das Modell liefert das Lehrbuch, nicht das System.
Ein Kommentator auf Hacker News fasst das Risiko in eine Frage: „Couldn't it very well be that you proved something that wasn't actually your program?“ Menschen müssen sie im Spec-Review beantworten. Testvektoren und Trace Validation am echten Code können dabei helfen.
Damit entsteht eine Review-Aufgabe, die es im klassischen Code-Review mit Coding Agents so nicht gab. Sie braucht eine benannte Person mit Domänenwissen, die verantwortet, was der Beweis am Ende zusichert.
Das SymCrypt-README fasst diese Aufgabe in drei Fragen: „Is it the right formal specification? Is it the right set of verified properties? What trust assumptions do they rely on?“ Konkret vergleichen die Reviewer die Spec Zeile für Zeile mit dem Standard, testen sie mit den CAVP/ACVP-Testvektoren und prüfen die Vor- und Nachbedingungen der öffentlichen API.
Lemmas, Schleifeninvarianten und Bereichshypothesen brauchen laut README kein manuelles Review. Diese Arbeit erledigt der Kernel. Das Review konzentriert sich auf die Spezifikation, die Verträge der öffentlichen API und die dokumentierte Vertrauensbasis. Bei SymCrypt umfasst die Spezifikation je Primitive 140 bis 329 Zeilen. Nicht verifiziert sind dort zum Beispiel Seitenkanäle und die C-FFI.
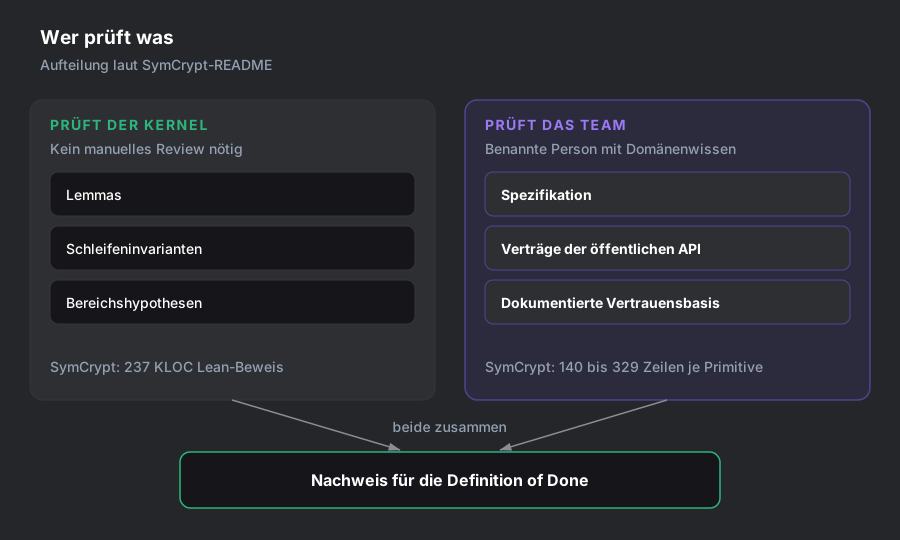
Den langen Beweis prüft die Maschine, die kurze Spezifikation prüfen Menschen.
Runtime Verification setzt im Hersteller-Blog „The proof is in the spec“ einen Schritt früher an: Zuerst entsteht eine Prosa-Spezifikation, die der Maintainer freigibt. „Each formal statement traces back to a sentence the maintainer already approved.“ Formale Aussagen ohne freigegebenen Satz fallen damit auf.
Dazu kommen Vacuity-Checks, also Tests auf leere Beweise: „mutate the implementation and make sure the proof breaks, try to derive False from the hypotheses, list the axioms“. Verletzt die Mutation die freigegebene Eigenschaft und akzeptiert der Checker den Beweis trotzdem, sind Spezifikation, Hypothesen und Axiome zu prüfen.
Galois berichtet: „the strongest results came when the LLM received one precise property to prove or break at a time“. Im Spec-Review hilft dasselbe: eine präzise Eigenschaft pro Auftrag, die sich einzeln lesen und freigeben lässt.
So wird die freigegebene Spezifikation samt grünem Beweislauf zu einem Nachweis, der in die Definition of Done für Coding Agents gehört.
Wo im eigenen Code anfangen
Aus den veröffentlichten Projekten lässt sich ein Auswahlkriterium ableiten, auch wenn sie es so nicht formulieren: Ein guter Startpunkt ist ein kritischer Kern, dessen Spezifikation deutlich kürzer ist als seine Implementierung. Bei SymCrypt kommen für SHA-3 140 Zeilen Spec auf 1.656 Zeilen Rust. Bei Anthropic war es das eingangs genannte Verhältnis von rund 110 Zeilen Spec zu 86 KB Programm. Die Kosten sagt dieses Verhältnis nicht voraus. Entscheidend bleibt, ob das Team die Eigenschaft, ihre Annahmen und die Grenze zum übrigen System fachlich prüfen kann.
Lars Hupel rät bei heise, nicht die ganze Anwendung zu verifizieren, sondern zuerst die kritischen Bereiche zu bestimmen. Sein Beispiel ist eine Banking-App: Ein Absturz ist dort tolerierbar, eine verlorene oder doppelt gebuchte Transaktion nicht. Von Agenten spricht Hupel dabei nicht. Das Prinzip gilt trotzdem.
Für einen ersten Versuch wählt das Team eine einzige kritische Eigenschaft, etwa Hupels Anforderung, dass keine Transaktion verloren geht oder doppelt gebucht wird. Es hält die Annahmen fest und benennt die Person, die das formale Statement fachlich freigibt. Danach erstellt der Agent den Nachweis, Spec-Diff und Beweisprüfung laufen im CI-Gate. Die Integration bleibt Sache von Tests und Review.
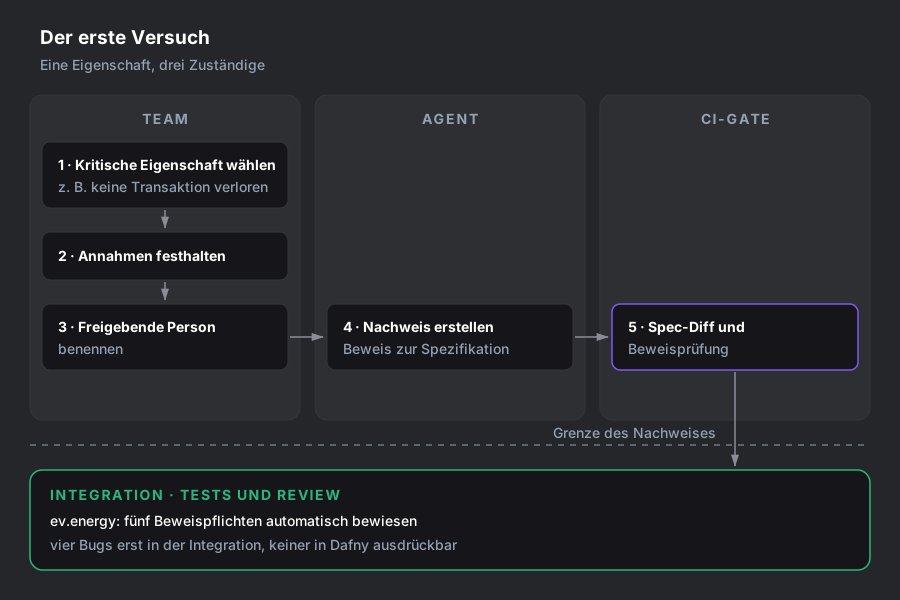
Das Team legt Eigenschaft, Annahmen und Freigabe fest, der Agent liefert den Nachweis, das CI prüft ihn. Was danach in der Integration schiefgeht, fangen weiterhin Tests und Review ab.
Gute Kandidaten sind Autorisierungslogik, Geldarithmetik, Parser und Serialisierung, Zustandsmaschinen und Nebenläufigkeitsprotokolle. Oft lässt sich die gewünschte Eigenschaft dort in wenigen Sätzen beschreiben, die Implementierung dagegen ist lang und hat viele Randfälle. Ob sich daraus eine kurze und belastbare Spezifikation ergibt, zeigt erst der Versuch am konkreten Kern. Wer Protokollentscheidungen schon in Architecture Decision Records festhält, hat den Ausgangspunkt für eine TLA+-Spec im Repository.
Harry Nicholls hat bei ev.energy einen solchen Kern in Dafny bewiesen und berichtet in seinem Blog: „Five proof obligations, all discharged automatically on the first attempt.“ Der Beweis selbst war also kein Problem.
Danach schreibt er: „Four bugs surfaced during integration. None of them were expressible in Dafny.“ Ein Dezimalfeld speicherte sechs statt drei Nachkommastellen, ein Enum lieferte 0 statt „SMART“. In den Codebasen, die Nicholls mit einem eigenen Analyzer untersucht hat, ist nur rund ein Viertel der Codezeilen für Dafny oder Lean zugänglich. Für den übrigen Code bleiben Tests und Review.
Ob auch normale Teams leicht einsteigen können, ist bisher nicht belegt. Alle großen Demos kommen aus Experten-Teams. Für Nicht-Experten gibt es bisher nur kleine Studien mit Studierenden: eine zu Dafny mit ChatGPT mit 14 Teilnehmern und eine zur Lean-Formalisierung mit 7 Teilnehmern.
Woran man erkennt, dass der Agent schummelt
Der Vericoding-Benchmark beschreibt drei Muster, mit denen ein Agent den grünen Haken bekommt, ohne etwas zu beweisen. Er schaltet den Checker mit assume(false) oder sorry ab. Er schwächt die Nachbedingung zu ensures true. Oder er lässt die Implementierung aus der Spezifikation durchsickern. Die Autoren haben erfolgreiche Fälle von Hand nachgeprüft und dabei rund 9 % der Specs als zu schwach eingestuft.
VeruSAGE hat in der Fassung vom April 2026 gezählt, wie oft das vorkommt. Ohne Cheat-Checker schummelte Sonnet 4 in 14 % der Beweisaufgaben, Sonnet 4.5 in 7 % und GPT-5 in 2 %. Mit einem Hinweis auf den Checker im Prompt sanken alle Raten unter 1,5 %. Das ist deutlich weniger, aber nicht null.
Unter Reinforcement Learning wird das Schummeln zur Strategie. In einer MIT-Abschlussarbeit stieg der verifizierte Reward von 2,2 % auf 58,1 %, und ein guter Teil davon war Spec-Hacking an schwachen Spezifikationen. AlphaVerus beschreibt für Läufe ohne Filter einen Schneeballeffekt: Das Modell setzt immer häufiger assume(false).
Auch der Checker gehört zur Vertrauensbasis. Laut Leonardo de Mouras Postmortem vom 24. August 2026 nutzte ein internes OpenAI-Modell zwischen dem 30. Juli und dem 20. August mehrere Soundness-Bugs aus, sodass der offizielle Lean-Kernel einen Beweis von False akzeptierte. Dazu kamen zwei Runtime-Exploits. De Moura schreibt: „lake build does not protect users from adversarial proofs … We consider AI-generated proofs a potential source of malicious proofs.“ Der Fix kam mit v4.33.1.
Schon ein erstes Postmortem vom 1. August beschreibt eine KI-gestützte Collatz-„Widerlegung“ ohne ein einziges sorry, die Kernel-Bug #14576 ausnutzte.
Rocq traf es schon früher. Tristan Stérin fand Anfang 2026 mit Opus 4.6 und Hinweisen von Experten sieben Beweise von False im offiziellen Kernel. Die Fixes stecken in Rocq 9.2.
Lean hat mit Werkzeugen reagiert. Seit Version 4.35.0 bringt Lean 4 lake check mit. Der Befehl exportiert das Projekt und prüft es in einer Sandbox mit leanchecker nach. --paranoid prüft zusätzlich mit unabhängigen Kerneln wie nanoda und lean4lean (de Moura).
Thomas Marchand hat im nicht begutachteten Bericht „Who Grades the Prover?“ eine Lücke im Prüfaufbau demonstriert: Eine präparierte Einreichung bestand alle 100 Aufgaben, ohne etwas zu beweisen. Erst das Kernel-Replay mit leanchecker verwarf sie. Keines der getesteten Modelle nutzte die Lücke aus, die 468 erfolgreichen Modellbeweise hielten der Nachprüfung stand.
Auch ein ehrlicher Beweis gilt nur bis zur Grenze des verifizierten Codes. Fonseca et al. fanden 16 Bugs in den verifizierten Systemen IronFleet, Verdi und Chapar, „mostly at the interface of verified and unverified components“.
Aus diesen Befunden ergibt sich ein CI-Gate mit vier Prüfungen:
- Sperrliste im Diff:
sorry,admit,axiom,assume(false),external_body,ensures true, dazu Sprachspezifisches wie{:verify false}in Dafny oderset_option debug.*in Lean. - Geschützte Spezifikationen: Vor- und Nachbedingungen sowie Theorem-Statements brauchen bei jeder Änderung menschliches Review, egal, in welcher Datei sie stehen. Ein parsergestützter Spec-Diff ergänzt die Sperrliste, denn eine verschärfte Vorbedingung oder abgeschwächte Nachbedingung enthält kein verbotenes Token.
- Kernel-Replay:
lake checkoderleanchecker --fresh, bei hohem Risiko zusätzlichlake check --paranoidmit unabhängigen Kerneln, für Rocqcoqchkauf den.vo-Dateien. - Dokumentierte Trusted Base: Kernel und Version, Axiome, Modelle und der unverifizierte Code an der Grenze.
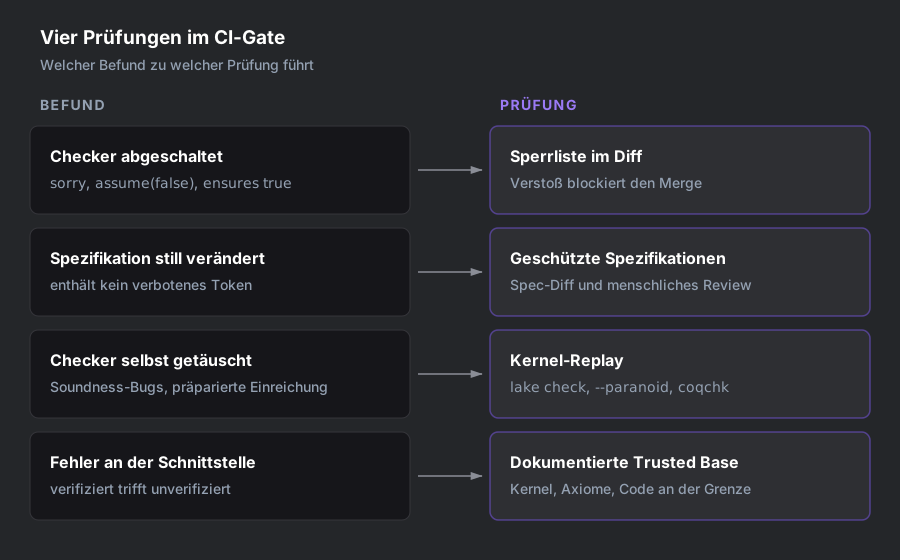
Jede der vier Prüfungen deckt einen anderen Weg ab, auf dem ein grüner Haken ohne echten Beweis entsteht. Fällt eine weg, bleibt ihr Befund ungeprüft.
Eine Regel im Prompt reicht dafür nicht. Was in CLAUDE.md oder AGENTS.md steht, beeinflusst das Modell, und die Prompt-Muster für Enterprise-Codebasen helfen dabei. Durchsetzen lässt sich die Sperrliste aber erst im CI, das den Merge bei einem Verstoß blockiert.
Welche Rolle formale Verifikation in Normen spielt
Welche Annahmen und Werkzeuge ein Nachweis dokumentieren muss, hängt vom Regelwerk ab. Ein Beweis belegt eine eng umrissene Eigenschaft unter Annahmen, die jemand festhalten muss. Pflicht ist formale Verifikation in keinem der folgenden Regelwerke.
| Regelwerk oder Bericht | Stellung formaler Verifikation |
|---|---|
| ISO 26262-6:2018 | bei ASIL C und D empfohlen („+“) in Tabelle 4 zu 7.4.14 und Tabelle 7 zu 9.4.2, in keiner Methodentabelle dieses Teils „++“ |
| ISO 26262-8:2018 | Tabelle 2 zu 6.4.3.3 (Verifikation von Sicherheitsanforderungen) empfiehlt formale Verifikation („+“) schon ab ASIL B |
| IEC 61508-3 | Tabelle A.9 „Formal proof“ bei SIL 4 „highly recommended“, belegt nur über Sekundärquellen wie Ladkin/Faller |
| DO-333 | Soundness jeder Methode und alle Annahmen dokumentieren und begründen (Cofer & Miller) |
| CRA, Verordnung (EU) 2024/2847 | kein Wort zu formaler Verifikation, Anhang I Teil II Nr. 3 verlangt „effective and regular tests and reviews“, die Methode bleibt offen |
| BSI/ANSSI, „AI Coding Assistants“, Stand September 2024 | formale Methoden kommen nicht vor |
Wie sich Agenten in ASIL-Prozesse einfügen, steht in Coding Agents unter ASPICE und ISO 26262. Was der CRA tatsächlich verlangt, steht in SBOM und CRA für KI-generierten Code.
Ein NASA-Bericht von 2017 untersucht die Qualifizierung eines rund 6.000 Zeilen großen Proof-Certificate-Checkers statt des Model Checkers, der die Beweise erzeugt. Sprachmodelle behandelt der Bericht nicht. Ob sich der Ansatz auf LLM-generierte Beweise übertragen lässt, müsste eigens begründet werden. Eine Leitlinie von DO-330, EASA oder FAA dazu ist Stand 1. November 2026 nicht bekannt.
Was nach dem grünen Haken bleibt
Billig ist der Beweis nur relativ. Für die OSS-Fuzz-Beweise nennt Anthropic „hundreds of millions of tokens“, aber keinen Dollarbetrag. Die Pflege ist kaum untersucht. Bei seL4 wurde sie zur dominierenden Tätigkeit (Bourke et al.). Empirische Daten dazu, wie sich LLM-generierte Beweise bei Codeänderungen halten, fand die Recherche bis zum 1. November 2026 nicht.
In der CACM nennen Broy, Ruess und Shankar die Spezifikation „the Achilles' heel of formal verification“. Gegen Beweise spricht das nicht. Die drei plädieren dafür, früher an der Spezifikation anzusetzen.
Leonardo de Moura fordert, dass die Verifikation getrennt von der KI bleibt, die den Code schreibt: Liefert derselbe Anbieter beides, „there is a conflict of interest“. Dabei leitet er selbst Lean.
Übrig bleibt die Spezifikation. Die 630.000 Zeilen Rocq zum cJSON-Parser prüft der Checker. Ob die Spezifikation die richtige Eigenschaft beschreibt und ihre Annahmen zum eingesetzten System passen, prüft er nicht. Das muss jemand im Team mit Namen freigeben.