
„They're isolated from production resources and the internet, so we can run minions on devboxes without human permission checks.“ Der Satz steht im ersten Teil von Stripes Bericht über die eigenen Coding Agents vom 9. Februar 2026. Die Minions, so heißen die Agenten bei Stripe, bitten also vor keinem einzelnen Schritt um Erlaubnis. Möglich ist das, weil die Devbox, eine Entwicklungsmaschine mit zehn Sekunden Startzeit, weder Produktionssysteme noch das Internet erreicht. Die Umgebung begrenzt den Schaden, deshalb muss niemand jeden Befehl freigeben.
Zehn Tage später lieferte Stripe im zweiten Teil die Zahl nach: über 1.300 gemergte Pull Requests pro Woche, im ersten Teil waren es noch 1.000. Das ist eine Selbstauskunft, und gezählt werden PRs. Aufschlussreicher ist ein Nachsatz im selben Text. Die Devboxes entstanden „for the needs of human engineers, long before LLM coding agents existed“. Die Isolation, die den Agenten die Freigabe pro Schritt erspart, musste Stripe nicht neu erfinden, es gab sie längst.
Wer Cloud Agents im eigenen Unternehmen freischalten will, steht damit vor einer anderen Frage als der nach dem besten Modell. Wenn die Umgebung die Kontrolle pro Schritt übernimmt, was bleibt dann beim Menschen, und was begrenzt am Ende den Durchsatz? Die Antwort hängt weniger am Produkt als an Rechten, Datenfluss und Abnahme. Für Produktfunktionen, Verfügbarkeit und Datenfluss gilt der Stand vom 28. September 2026.
Background Agents und Cloud Agents: Arbeit, bei der niemand zusieht
Ein Background Agent oder Cloud Agent ist ein Coding Agent, der in einer eigenen, vom Rechner des Entwicklers getrennten Umgebung läuft und dort weiterarbeitet, auch wenn der Laptop zugeklappt ist. Sein Lebenszyklus beginnt mit einem Auftrag oder Auslöser und endet mit einem Ergebnis, meist einem Branch oder Pull Request, den ein Mensch abnimmt.
Wie Coding Agents im Unternehmen grundsätzlich eingeführt werden, beschreibt der Leitfaden zu KI-Coding-Agents. Dieser Text behandelt die Stufe, bei der während der Arbeit niemand mehr zusieht.
Wie wenig am Namen hängt, zeigen die Umbenennungen. Cursor führte mit Version 0.50 am 15. Mai 2025 den „Background Agent“ ein: „The agents run in their own remote environments.“ Mit Cursor 2.0 am 29. Oktober 2025 hießen sie Cloud Agents. GitHub benannte am 1. April 2026 den Copilot coding agent in Copilot cloud agent um. Der Begriff hat sich geändert, die Betriebseigenschaft ist gleich geblieben.
Codex cloud oder lokal, Remote Control oder Cloud Session: Was weiterläuft, wenn der Laptop zu ist
Das Wort „Background“ taugt nicht als Ortsangabe. Anthropic nennt lokale Sitzungen in der Agent View „background sessions“, und die Doku stellt klar: „Shutting down or restarting your machine stops running background sessions.“ Tragfähiger ist deshalb eine Dreiteilung danach, ob die Arbeit bei zugeklapptem Laptop weiterläuft.
Lokal laufen der Agent Mode in der IDE, die CLI und lokale Background Sessions. Sie enden, sobald der Rechner ausgeht. Laut GitHub arbeitet der Agent Mode „directly in your local development environment“, der Cloud Agent dagegen in einer Umgebung auf Basis von GitHub Actions. Das ist der Unterschied zwischen Copilot coding agent und Agent Mode.
Bei Claude Code steuert Remote Control nur den eigenen, lokalen Prozess aus der Ferne. Für den Befehl claude remote-control gilt laut Doku: „your computer has to stay on“. Eine Cloud Session startet mit claude --cloud (--remote ist ein veralteter Alias) und „keeps running after you close your laptop“.
Bei OpenAI verläuft die Grenze mitten durch ein Feature. Codex cloud arbeitet in isolierten Cloud-Umgebungen und lässt sich über das Web, GitHub, GitLab (Beta) oder Slack starten. Die Scheduled Tasks brauchen einen eingeschalteten Rechner nur, wenn sie lokale Dateien bearbeiten: „Keep the computer on and the app running when a scheduled task needs local files.“
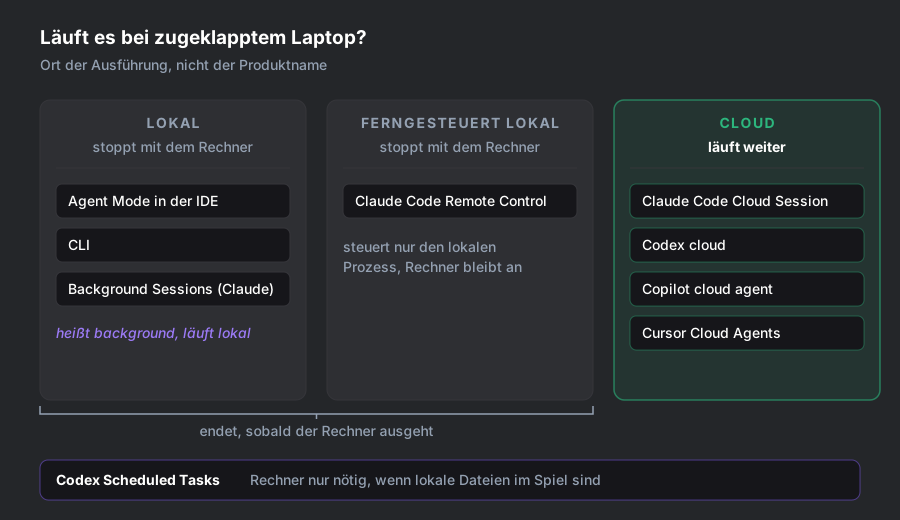
Ob ein Agent weiterarbeitet, entscheidet der Ausführungsort, nicht das Wort „Background“ im Produktnamen. Nur die rechte Spalte läuft bei zugeklapptem Laptop weiter.
Ein Subagent ist kein eigener Dienst. Laut Anthropic arbeitet er „within a single session“ und läuft deshalb am selben Ort wie die übergeordnete Session. Wie weit ein Agent dagegen auf dem eigenen Rechner zugreifen darf, behandelt ein eigener Artikel.
Drei Muster, die unter demselben Namen laufen
Unter den Produktnamen stecken drei Betriebsformen: ein einzelner Auftrag, ein durch Zeitplan oder Ereignis ausgelöster Lauf und die Koordination mehrerer Agenten.
Das erste Muster ist der Auftrag: ein Ticket, eine Umgebung, ein Pull Request. Der Copilot cloud agent pusht dabei nur auf einen copilot/-Branch. Codex cloud nimmt Aufgaben über die oben genannten Kanäle an und bearbeitet sie jeweils in einer eigenen Umgebung (beides Stand: 28. September 2026).
Beim zweiten Muster startet ein Zeitplan, ein API-Aufruf oder ein Ereignis im Repository die Arbeit. Claude Code Routines sind als Research Preview für die Tarife Pro, Max, Team und Enterprise verfügbar und reagieren auf Zeitpläne, API-Aufrufe sowie Pull Requests und Releases auf GitHub. Jedes Ereignis startet laut Doku eine frische Session: „two PR updates produce two independent sessions“. Der zweite Lauf übernimmt also keinen Sitzungskontext aus dem ersten.
Copilot Automations folgen demselben Muster. Sie starten nach Zeitplan, bei neuen Issues und bei geöffneten oder aktualisierten Pull Requests, allerdings nur in privaten und internen Repositories (Stand: 28. September 2026).
Das dritte Muster ist die Koordination, und im September ist es greifbar geworden. Cursor Projects ging am 10. September als Beta an den Start. Der Koordinator dort schreibt selbst keinen Code („doesn't write code itself“), sondern plant die Arbeit und verteilt sie an Agenten, die sie umsetzen.
Bei den am 17. September neu gestalteten Claude Projects ist jeder Thread eine Claude-Code-Cloud-Session mit eigenem Branch und eigener Kopie des Repositorys. Das Ganze ist eine Beta für ausgewählte Pro- und Max-Nutzer. Die Cloud-Sessions selbst sind laut Anthropic seit dem 23. September allgemein verfügbar (@ClaudeDevs auf X, Doku).
Oft stecken alle drei Muster im selben Produkt. Vor der Freischaltung lassen sie sich mit vier Fragen auseinanderhalten:
- Was startet die Arbeit: ein Mensch, ein Zeitplan, ein Ereignis im Repository oder ein Koordinator?
- Wo läuft sie, auf welcher VM oder welchem Runner und mit welchem Netzwerkzugang?
- Was darf der Agent ändern, auf welchen Branches und unter wessen Identität?
- Was beweist, dass sie fertig ist?
„It does not mean the task in your prompt succeeded.“ Der Satz steht in der Routines-Doku (Stand: 28. September 2026) und bezieht sich auf den grünen Status in der Liste der Läufe. Grün heißt dort nur, dass die Session ohne Infrastrukturfehler gestartet und wieder beendet wurde. Was der Agent tatsächlich getan hat, steht im Transkript.
Die vierte Frage ist die unbequemste. Beim Auftrag liegt im Erfolgsfall ein prüfbarer Pull Request vor. Garantiert ist er nicht. Bei ausgelösten Läufen zeigt die Liste oft nur einen Status an, und der ist laut Hersteller selbst kein Erfolgsnachweis.
Die Agenten sind im Einsatz, der Nutzen steht auf einem anderen Blatt
Die eingangs genannten Stripe-PRs stammen vollständig von Agenten, trotzdem durchläuft jeder ein menschliches Review, „while they're human-reviewed“, wie es im ersten Teil heißt. Die Begründung für den ganzen Aufbau liefert Stripe gleich mit: „one of our most constrained resources is developer attention“. Ein Stripe-Engineer öffnet den PR und bittet eine Kollegin oder einen Kollegen um das Review.
Bei Ramp schreibt der Background Agent Inspect laut Ramp rund 30 Prozent der gemergten PRs in den Frontend- und Backend-Repos (Januar 2026). Ein Detail fällt auf: Inspect öffnet PRs mit dem GitHub-Token des Nutzers, nicht mit einer App-Identität. Ramp begründet das so: Eine App-Identität würde es im eigenen Ablauf jedem Nutzer erlauben, seine eigenen Änderungen freizugeben. Mit dem Nutzertoken soll die Abnahme bei einer zweiten Person bleiben.
Cursor meldet im September 2026, dass Cloud Agents intern mehr als 60 Prozent der gemergten PRs erzeugen. Das ist die Selbstauskunft eines Anbieters über sein eigenes Produkt. Wie alle Zahlen in diesem Abschnitt erfasst die Quote PRs, nicht den Wert der Arbeit.
Spotify zeigt, wo das Muster an seine Grenze stößt. Laut Spotify (22. April 2026) stand in dbt- und BigQuery-Repos ohne Build-Zeit-Tests die Selbstverifikation des Agenten Honk nicht zur Verfügung („unavailable to us“), die Teams mussten von Hand testen. Wo die Umgebung keinen automatischen Nachweis liefert, bleibt das Testen beim Menschen.
Wo der Nachweis funktioniert, verschiebt sich das Problem. Auf der QCon London 2026 berichtete Spotify, dass 1.000 gemergte Migrations-PRs früher drei Monate brauchten, heute zehn Tage. Zum Review hieß es dort: „This is becoming the new bottleneck“.
MirrorCode von Epoch AI und METR untersucht eine engere Frage: Wie weit kommen Agenten beim Nachbau präzise beschriebener Programme? In der Paperfassung vom 29. Juni 2026 erreicht Claude Opus 4.7 über 25 Programme hinweg 56 Prozent. Beim Nachbau von gotree liefen 2.000 von 2.001 Tests durch. Die Autoren schränken ein, das gelte „especially when requirements are precisely specified“. Ohne sichtbare Tests fielen die Ergebnisse schlechter aus. Das ist ein Fähigkeitsbeleg unter Testbedingungen, keine Messung von Review-Aufwand oder Unternehmensproduktivität.
Die METR-Umfrage vom 11. Mai 2026 (n = 349) misst Wahrnehmungen, keine Produktivität: Die Befragten fühlen sich im Median dreimal so schnell und schätzen den Wert ihrer Arbeit auf das 1,4- bis 2-Fache. Das sind gefühlte Werte, und METR schreibt selbst, die Antworten seien „not necessarily grounded in reality“.
Der Faros-Report 2026 vergleicht je Team die Quartale mit der niedrigsten und der höchsten KI-Nutzung (Stand: März 2026). Das PR-Review dauert im Median 441,5 Prozent länger, die Zahl der ohne Review gemergten PRs liegt 31,3 Prozent höher. Die zweite Zahl ist eine relative Zunahme, kein Anteil. Beides sind Herstellerdaten, und beide zeigen Zusammenhänge, keine Ursachen.
Yoshioka et al. berichten für den öffentlichen Datensatz AIDev: 77,5 Prozent der gemergten Agenten-PRs und 57,6 Prozent der gemergten PRs von Menschen wurden vom selben Konto geöffnet und gemergt. Das ist keine Quote fehlender Reviews. Duma et al. finden im selben Datensatz bei 61,38 Prozent der Agenten-PRs gar kein Review. Beide Zahlen betreffen öffentliche GitHub-Repos, keine Unternehmensrepos.
Die Quellen messen also Verschiedenes: Unternehmensberichte zählen gemergte PRs, MirrorCode prüft abgegrenzte Programmieraufgaben, Faros und AIDev beschreiben Review-Muster in Herstellertelemetrie und in öffentlichen GitHub-Repos. Eine gemeinsame Produktivitätsquote für Unternehmenspiloten ergibt sich daraus nicht. Offen bleibt, was aus der gesparten Zeit wird: in schnellerer Auslieferung oder in einer längeren Schlange vor der Abnahme.
Kontrolle gehört nicht in den Prompt
„Nicht deployen“ im Prompt ist eine Bitte an das Modell. Zur Kontrolle wird der Satz erst, wenn Rechte, Budgets oder die Umgebung ihn durchsetzen. Wie weit die Voreinstellungen davon entfernt sein können, zeigt wieder die Doku zu Routines: „there is no permission-mode picker“, die Session ruft eingebundene Connectors auf, „including writes, without asking for permission during a run“.
Dazu kommt die Identität. „Anything a routine does through your connected GitHub identity or connectors appears as you“, Commits und Pull Requests laufen also unter dem eigenen GitHub-Konto. Wer eigentlich handelt, wenn der Agent committet, erklärt der Beitrag zur Agent-Identität bei Coding Agents. Außerhalb des Prompts begrenzen Routines Pushes auf claude/-Branches und setzen eine Netzwerk-Allowlist sowie Tages- und Stundenobergrenzen. Connector-Verkehr läuft an dieser Allowlist vorbei.
Das Gegenmuster dokumentiert GitHub für Agentic Workflows: „The generated agent job uses read-only permissions by default.“ Schreiben geht nur über Safe Outputs. Der Agent fordert eine Aktion als strukturierte Ausgabe an, ein separater Job mit eigenen Rechten führt sie aus. Standardmäßig sind pro Lauf höchstens ein PR, ein Issue und ein Kommentar erlaubt. Für den Agentenschritt sind laut Doku 20 Minuten vorgesehen, das Budget liegt standardmäßig bei 1.000 AI-Credits pro Lauf.
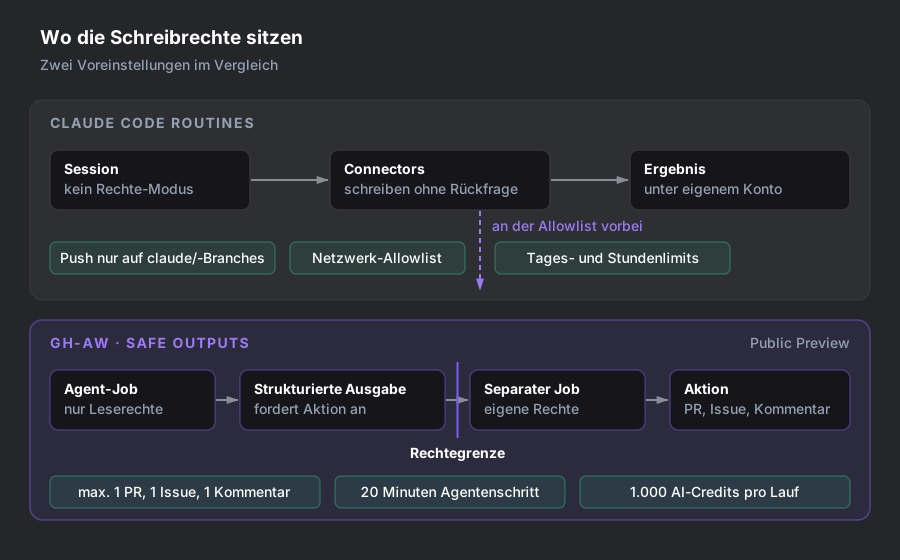
Bei Routines schreibt die Session selbst, und der Connector-Verkehr umgeht die Allowlist. Bei Safe Outputs fordert der Agent eine Aktion nur an, ausführen darf sie erst ein Job mit eigenen Rechten.
Laut Doku schaltet max-ai-credits: -1 die Budgetsteuerung ab, auch der Strict-Modus lässt sich abschalten. Stand 28. September 2026 ist gh-aw in der Public Preview, nicht GA.
Stripe zieht die Grenzen in der eigenen Umgebung: eine bewusst kleine Auswahl aus nahezu 500 MCP-Werkzeugen, Blueprints, die Schritte wie „Run configured linters“ und „Push changes“ als deterministischen Code ohne LLM-Aufruf ausführen, und höchstens zwei CI-Runden pro Aufgabe. Danach heißt es bei Stripe: „we send the branch back to its human operator for manual scrutiny.“ Die Zahl der Runden ist begrenzt, die Abnahme bleibt beim Menschen.
Wie nicht vertrauenswürdige Eingaben mit weitreichenden Werkzeugrechten und Secrets zusammenwirken, zeigen dokumentierte Vorfälle. Keiner betrifft ein kommerzielles Cloud-Agent-Produkt, alle betreffen Agenten in CI oder auf dem Desktop. Laut Adnan Khan und dem Post-Mortem von Cline übernahm ein Triage-Workflow mit claude-code-action und breiten Werkzeugrechten den Issue-Titel in den Prompt. Über Cache-Poisoning gelangten Angreifer an Publish-Tokens, bei der anschließenden Rotation wurde das falsche npm-Token gelöscht. Am 17. Februar 2026 erschien die unautorisierte Version cline@2.3.0 und blieb rund acht Stunden auf npm.
Das Muster aus fremder Eingabe, Schreibrechten und Secrets kehrt wieder: laut Invariant Labs bei einem Desktop-Agenten mit GitHub-MCP, laut Aikido („PromptPwnd“) und Aonan Guan („Comment and Control“) bei Agenten in GitHub Actions. Der Microsoft Security Blog empfiehlt am 5. Juni 2026 die „Agents Rule of Two“: fremde Eingaben, Secrets und externe Kommunikation nie zusammen im selben Workflow.
„Selbst gehostet“ beantwortet die Datenfrage noch nicht
Cursor formuliert es für Self-Hosted Machines selbst: „The agent loop stays in Cursor's cloud. Your machine runs the tools.“ Tool-Ausgaben mit Code fließen zur Inferenz zurück, Artefakte gehen laut Doku in einen S3-Bucket in us-east-1, und wo das Transkript liegt, bleibt offen. Genauer gesagt: Der Code wird bei Cursor verarbeitet. Dazu kommt die Freigabe von Artefakten: Mit der Option „Allow posting artifacts to GitHub“ sind Screenshots, Videos und Logs in PR-Beschreibungen laut Doku über lange, nicht erratbare URLs ohne Anmeldung abrufbar. Das ist eine andere Frage als die Speicherregion.
Bei Anthropics selbst gehosteten Umgebungen bleiben Checkouts und Secrets lokal, aber „Anthropic stores the session transcript“. Die OpenAI Agents API unterstützt nur US-Datenresidenz und keine Zero Data Retention (ZDR), Codex Web ist von der EU-Datenresidenz ausgenommen. Coder Agent Relay und Cloudflare Sandboxes verlagern ebenfalls nur die Ausführung, Orchestrierung und Inferenz bleiben beim Anbieter.
Unter den geprüften Angeboten verspricht nur GitHub Copilot mit Datenresidenz für den Cloud Agent Inferenz und Logs in der EU, laut Herstellerangabe. Voraussetzung sind GHE.com, eine aktivierte Opt-in-Richtlinie und regional zertifizierte Modelle (Stand: 28. September 2026).
Für jedes Angebot braucht es deshalb fünf getrennte Antworten: Wo wird der Code ausgeführt, wo verarbeitet das Modell die Daten, wo liegen Logs und Artefakte, wo liegen Zugangsdaten, welches Netz erreicht der Agent? Was davon datenschutzrechtlich zählt, klärt der Beitrag Coding Agents und DSGVO.
Parallel heißt nicht schneller: Der Engpass wandert zur Abnahme
Parallele Agenten arbeiten getrennt, ihre Arbeit läuft am Ende trotzdem an einer Stelle zusammen. Bei den oben beschriebenen Claude Projects sagt Anthropic das ohne Umschweife: Überschneiden sich zwei Threads, erscheint das als gewöhnlicher Merge-Konflikt.
Dahinter wartet die Abnahme. Jeder zusätzliche Lauf kann einen weiteren Change erzeugen, und jeder Change braucht eine festgelegte Abnahme, durch einen Reviewer oder nach vorab vereinbarten Regeln für risikoarme Änderungen. Abnahme meint hier beides, das Review des Codes und die Freigabe durch Security oder Compliance. Beide können getrennt voneinander stauen. Wie das Review so zum Engpass wird, zeigt der Beitrag zum Engpass Pull Request. Treffen mehr prüfbare Changes ein, als das Team abnehmen kann, wächst die Warteschlange. Damit kann die Reviewkapazität begrenzen, wie viele Läufe parallel sinnvoll sind, nicht das Kontingent an Cloud-Sessions. Das beschreibt einen Mechanismus und ein Risiko, keinen Messwert. Die Quellen messen den Zusammenhang für unbeaufsichtigte Agenten nicht direkt. Ob die Abnahme im eigenen Piloten tatsächlich die Auslieferung begrenzt, muss dort gemessen werden. Und selbst wenn die Abnahme mitkommt, ist der Engpass nicht verschwunden. Er kann nach vorn wandern, zu unklaren Anforderungen und offenen Entscheidungen, aus denen ein Agent schnell sehr viel Code macht.
Die Vorreiter prüfen deshalb nicht alles gleich streng, sondern staffeln die Abnahme nach Risiko. Zalando berichtet am 14. August 2026 von einem Freigabe-Bot, der die als risikoarm eingestuften PRs automatisch genehmigt, rund ein Drittel des Aufkommens. Zalando arbeitet dabei überwiegend interaktiv, übertragbar ist also das Prinzip, nicht die Zahl.
Mit dem Merge ist die Abnahme nicht vorbei. Cursor Rollouts (23. September 2026, nur Teams und Enterprise) vergleicht nach dem Deploy die Signale mit der Baseline davor. Bei einer Regression benachrichtigt es je nach Konfiguration den Autor, pausiert den schrittweisen Rollout oder erstellt einen Revert-PR, der auf Freigabe wartet. Automatischer Rollback und Feature-Flag-Integration sind angekündigt, am 28. September aber nicht ausgeliefert.
Gezählt werden muss deshalb nicht der Agentenlauf, sondern der akzeptierte Change. Eine mögliche Pilotkennzahl sind die Lauf- und Reviewkosten pro akzeptiertem Change. Für eine abgeschlossene Pilotserie werden alle Laufkosten einschließlich verworfener Versuche addiert. Dazu kommen die Review-Stunden bis zur Freigabe, bewertet mit einem intern festgelegten Stundensatz. Die Summe wird durch die Zahl der gemergten Changes geteilt. Allein reicht die Kennzahl nicht. Daneben gehören die Zeit vom Auftrag bis zur Auslieferung und ein Schutzsignal, etwa Nacharbeit oder Rücknahmen nach dem Merge. Sonst sinken die Kosten pro Change, während die Fehler zunehmen. Dafür müssen Läufe, Kosten, Review-Zeit und Abnahmeentscheidung je Auftrag zusammengeführt werden. Die Kennzahl ergänzt das Metrik-Set für Coding Agents, weil sie Durchsatz und Prüfaufwand in einer Zahl zusammenführt.
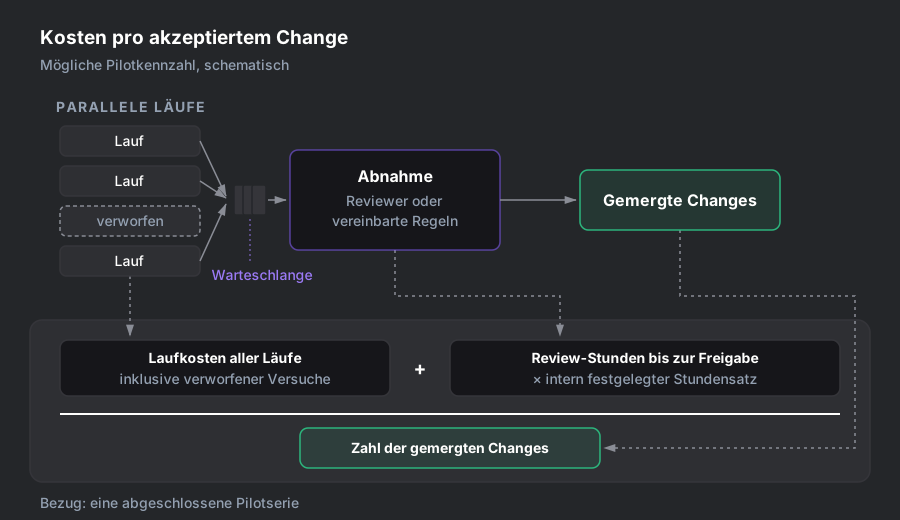
In den Zähler gehören auch verworfene Läufe und die Review-Stunden, in den Nenner nur gemergte Changes. Deshalb zeigt die Kennzahl, wenn die Abnahme den Takt vorgibt.
In den bis zum 28. September 2026 geprüften Quellen fand sich keine belastbare öffentliche Messung, die Laufkosten einschließlich verworfener Versuche und Review-Arbeit pro akzeptiertem Change zusammenführt. Am nächsten kommen Herstelleranleitungen, die KI-Kosten durch die Zahl gemergter PRs teilen und die Review-Arbeit weglassen. Damit fehlt ausgerechnet der Posten, der am ehesten den Takt vorgibt. Wer die Zahl braucht, muss sie im eigenen Piloten erheben.
Was sich heute für einen Piloten eignet und was nicht
Ob ein Auftrag in den Hintergrund darf, entscheidet die Umgebung und nicht das Modell. Belegt sie, dass die Arbeit stimmt? Und bleibt ein Fehler auf die eigene Devbox begrenzt? Das Raster führt die Risiko-Lanes aus dem Layering-Artikel weiter. Jede Stufe setzt die Bedingungen der vorherigen voraus: begrenzte Rechte, einen verabredeten Nachweis und eine Abnahme, die jemand verantwortet.
| Stufe | Typischer Auftrag | Was die Umgebung liefern muss | Empfehlung für den Erstpiloten |
|---|---|---|---|
| Begrenzte Aufgabe mit Akzeptanzkriterien | Bugfix mit Reproduktion, Abhängigkeits-Update in einem Repo | Tests, die den Fehler zeigen, CI als Nachweis, Push nur auf einen Agenten-Branch | Pilotkandidat |
| Wiederkehrende Wartung | Nächtlicher Lauf per Zeitplan, etwa Abhängigkeits-Updates als Draft-PR | eng begrenzte Rechte, Budget pro Lauf und Tag, benannter Owner | Pilotkandidat, wenn zusätzlich Trigger-Filter, Laufgrenzen, Budget und Owner feststehen |
| Koordination über Repos oder viele parallele Agenten | Migration über mehrere Services, ein Koordinator verteilt Threads | Integrationstests über Repo-Grenzen, Abnahmekapazität für viele parallele Changes | Fortgeschritten |
| Offene, produktionsverändernde Autonomie | Agent reagiert selbst auf Regressionen nach dem Deploy | Rollback, Deploy-Freeze und Feature Flags | nicht Teil eines Erstpiloten |
Wo zur Build-Zeit keine Tests laufen, endet die Tabelle schon vor der ersten Zeile, wie das Spotify-Beispiel oben zeigt. Für einen unbeaufsichtigten Piloten empfiehlt sich deshalb eine klare Grenze: Ohne automatisierte Tests fehlt der Nachweis, und ohne Nachweis gehört nicht einmal die kleinste Aufgabe in Stufe 1.
Beim Schritt von Stufe 1 zu Stufe 2 kommt zu den technischen Grenzen eine organisatorische Frage hinzu. Ein Auftrag, der jede Nacht läuft, braucht wie jeder Pilot mit Owner und Budget eine Person, die ihn verantwortet und seine Kosten kennt.
Ein Auftrag für Stufe 1 kann so aussehen (gekürzt):
Auftrag: Fehler aus dem verlinkten Ticket beheben.
1. Zuerst einen Regressionstest schreiben, der vor dem Fix fehlschlägt.
2. Keine bestehende Assertion abschwächen, löschen oder überspringen.
3. Ergebnis als Draft-PR: ausgeführte Befehle mit Ausgabe, offene Annahmen.
4. Kein Merge, kein Deploy.
5. Fehlen Rechte, Daten oder eindeutige Anforderungen: abbrechen, Blocker melden.
Der Auftrag legt fest, was als Nachweis zählt. Ob Punkt 2 eingehalten wurde, prüft besser ein getrennter Prüfer als der Agent selbst. Wer danach das Ergebnis abnimmt, sollte ebenfalls vorher feststehen, wie im Artikel Code Review mit Coding Agents: wer prüft wen beschrieben.
Punkt 4 bleibt trotzdem nur Text. Token-Rechte, Branch-Schutz und Netzwerkregeln müssen die harte Grenze durchsetzen, damit sie auch dann hält, wenn der Agent den Auftrag ignoriert.
Stand 28. September 2026 passen drei der neuen Funktionen nur eingeschränkt in einen Unternehmenspiloten. Claude Projects bleibt vorerst eine Beta für Einzeltarife, Team und Enterprise sollen „later“ folgen. Copilot Automations laufen nur in privaten und internen Repositories und zudem nicht in Repos von Managed User Accounts. Bei Cursor Rollouts ist die Anbindung an Feature Flags und Deploy-Freezes erst als „coming soon“ angekündigt. Offene, produktionsverändernde Autonomie gehört ohnehin nicht in einen Erstpiloten.
Wie Teams solche Aufträge formulieren, eigene Prüfer aufbauen und gemeinsame Freigaberegeln festlegen, zeigt das Enablement Coding Agents meistern.
Was der grüne Haken beweist
Der grüne Status der Routines, von dem bei den vier Prüffragen die Rede war, bestätigt laut Hersteller den Lauf, nicht den Erfolg des Auftrags.
Zwischen dem Haken und erledigter Arbeit liegen vier Stufen, und keine belegt die nächste:
- Die Umgebung lief.
- Ein Ergebnis liegt vor, als Branch, Diff oder Pull Request.
- Die Akzeptanzprüfungen sind bestanden, also die Tests, die vor dem Lauf festgelegt wurden.
- Das Ergebnis hat die festgelegte Abnahme durchlaufen, nach Regeln, die eine benannte Person verantwortet.
Die ersten drei Stufen kann die Umgebung nachweisen, auch wenn niemand zusieht. Die vierte kann sie nicht allein liefern. Laufen Coding Agents im Hintergrund, übernimmt die Umgebung die Schrittkontrolle, und die Verantwortung für die Abnahme bleibt beim Menschen, auch wenn risikoarme Changes nach vereinbarten Regeln automatisch durchgehen. Wird die Kapazität für diese Abnahme knapp, begrenzt sie den Durchsatz, egal wie viele Agenten gleichzeitig grün melden.