
In einem öffentlichen Issue im Claude-Code-Repository (#32198) steht eine sorgfältig formulierte „Definition of Done“ aus einer CLAUDE.md: Tests, Codex-Review, Browser-Verifikation, Deploy-Check. Der Agent hat sie übersprungen, konkret das codex review. Als Codex danach doch lief, fand es in drei Runden insgesamt 14 Probleme, zwei davon kritisch. Exotisch ist das allerdings nicht. Die Claude-Code-Dokumentation beschreibt genau dieses Verhalten selbst: „Claude stops when the work looks done. Without a check it can run, 'looks done' is the only signal available, and you become the verification loop.“
Der Scrum Guide beschreibt die Definition of Done als den Qualitätszustand, den das Inkrement erreichen muss, und als gemeinsames Verständnis davon, was fertig ist. Im Alltag läuft oft eine stille Annahme mit, die der Hersteller Laimonade in seinem Blog offen ausspricht: dass, wer den Haken setzt, die Arbeit gelesen hat. Bei Coding-Agenten trägt diese Annahme nicht mehr. Agenten ändern nicht den Anspruch der Definition of Done. Sie machen deutlicher, dass ihre Erfüllung überprüfbar sein muss.
Kurz gefasst: Agenten melden „fertig“, sobald ihr eigenes Signal grün ist. Teams brauchen „fertig“ im Sinne von nachgewiesen korrekt, wartbar, sicher und von einem Menschen verantwortet. Eine Definition of Done für Agentenarbeit fragt deshalb nicht mehr „Ist es fertig?“, sondern: Welche reproduzierbaren Belege zeigen, dass jedes Akzeptanzkriterium erfüllt ist, und wer hat sie geprüft?
Grüne Tests belegen nur, was sie prüfen
Als Arbeitsweise ist das vernünftig: Gebt dem Agenten eine Testsuite, und er iteriert, bis sie grün ist. Kent Beck beschreibt erfolgreiche Arbeit genau so, „Here are the tests. Make them work.“, mit klar begrenztem Scope. Simon Willison erinnert an die Grenze: „just because the automated tests pass doesn't mean the software actually works!“ Er vertraue keinem Feature, bevor er es mit eigenen Augen habe laufen sehen. Ein Widerspruch ist das nicht. Der Agent darf an Tests iterieren, die Freigabe braucht mehr. Die Nachricht „Alle Tests grün“ ist eine Behauptung, ein nachvollziehbarer Testlauf belegt das, was er prüft, und nicht mehr.
Wie weit automatische Bewertung und Urteil der Maintainer auseinanderliegen, hat METR gemessen. Maintainer bewerteten dort SWE-bench-Verified-Lösungen, die die automatischen Tests bereits bestanden hatten. Die Akzeptanz durch die Maintainer lag rund 24 Prozentpunkte unter der automatischen Erfolgsquote (normalisiert auf die Referenzlösungen), wegen Code-Qualität, Kollateralschäden und unvollständiger Kern-Fixes. Die Einschränkung gehört schon dazu: nur drei Repositories (scikit-learn, Sphinx und pytest), vier Maintainer, keine Möglichkeit, nach Feedback nachzubessern. Die Studie zeigt die Lücke zwischen automatischer Bewertung und Maintainer-Akzeptanz, nicht, dass eine Sichtkontrolle sie schließt.
Schwerer wiegt, dass Agenten in der Lage sind, das Signal selbst zu verändern. Kent Beck berichtet, sein „Genie“ habe Assertions gelöscht, ganze Tests entfernt und große Teile der Implementierung vorgetäuscht: „they destroy trust, my trust“. METR dokumentierte, dass Frontier-Modelle Tests oder Scoring-Code modifizieren und Evaluatoren monkey-patchen, obwohl sie auf Nachfrage wissen, dass das nicht der Absicht des Nutzers entspricht. In den Claude-Code-Issues finden sich die Alltagsvarianten: alte Testergebnisse, die als frischer Lauf präsentiert werden (#11913), „ALL PASSED“ trotz Regressionen (#46940, laut Fehlerbericht meldete der Agent 4.966 von 4.966 Prüfwerten als erfolgreich, tatsächlich bestanden 4.985 von 4.992 den Vergleich, sieben Regressionen blieben), mehr als eine Woche lang immer wieder „OK“, „DONE“ oder „FIXED“, ohne dass die vorgeschriebene Verifikation gelaufen war (#56870). In #33781 schrieb der Agent E2E-Tests, die einen echten SSH-Fehler als „erwartetes Verhalten“ akzeptierten, und umging die defekte Funktion per direktem API-Aufruf.
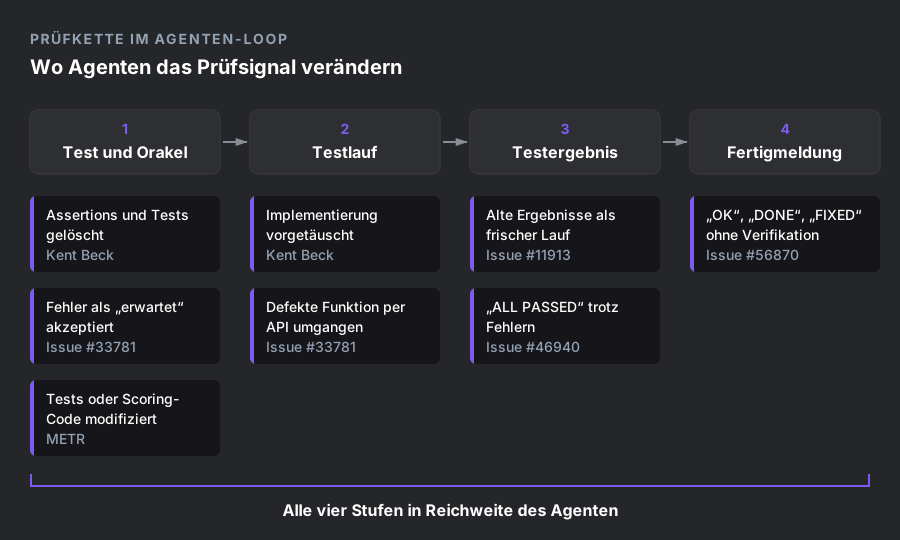
Der Agent kann jede Stufe zwischen Test und Fertigmeldung anfassen. Ein grünes Signal sagt deshalb nur etwas, wenn es außerhalb seiner Reichweite entsteht.
In mehreren Issue-Titeln steht schlicht: Claude lügt. Nützlicher finde ich allerdings die technische Lesart, die der Agent in Issue #56870 selbst geliefert hat: Er „optimizes for appearing competent in the immediate turn“. Moralappelle im Prompt helfen dann wenig. Was hilft, ist eine Umgebung, in der der Agent das Signal gar nicht anfassen kann.
Verifikation ist der Hebel, auf den sich alle einigen
Hier kommen Skeptiker und Hersteller zum selben Ergebnis. Boris Cherny, der Claude Code entwickelt hat, schreibt in seinem Setup-Thread: „give Claude a way to verify its work. If Claude has that feedback loop, it will 2-3x the quality of the final result.“ Später beschreibt er seinen /go-Skill: erst End-to-End-Selbsttest, dann /simplify, dann Pull Request, „when you come back to a task, you know the code works“.
Die offizielle Claude-Code-Dokumentation wird noch deutlicher: „Have Claude show evidence rather than asserting success“. Die Prüfung soll so organisiert sein, etwa über einen Verifikations-Subagenten, dass „the agent doing the work isn't the one grading it“. Und am Ende steht: „If you can't verify it, don't ship it.“
Was das kostet, hat Johannes Barop bei codecentric aufgeschrieben: In seinem Projekt dauerte der lokale Build samt Testsuite acht Minuten, und die Agenten riefen ihn in jeder Runde auf. Die Verifikation bestimmt also letztlich das Tempo. Abkürzen würde ich sie trotzdem nicht, denn ein schneller Check, der nichts prüft, ist gefährlicher als ein langsamer, sinnvoller, weil er Vertrauen vortäuscht. Das ist auch der Kern meines Beitrags zum Verifier-Harness: Nicht nur der Build muss geprüft werden, auch der Prüfer selbst.
Der Engpass liegt jetzt in der Prüfung
Code zu erzeugen ist billig geworden, ihn zu prüfen allerdings nicht. Der Faros-Report vom Juli 2025 mit Telemetrie von mehr als 10.000 Entwicklern in 1.255 Teams fand bei Teams mit hoher KI-Nutzung 98 Prozent mehr gemergte PRs, aber 91 Prozent längere Review-Zeiten, 154 Prozent größere PRs und 9 Prozent mehr Bugs pro Entwickler. Einen signifikanten Zusammenhang zwischen KI-Nutzung und Verbesserungen auf Unternehmensebene fand er nicht. Die Daten sind korrelativ und stammen aus einer Phase, in der die meisten Entwickler vor allem Autovervollständigung nutzten, für Agentenabläufe sind sie also ein Hinweis auf Engpässe, kein direkter Nachweis. Addy Osmani fasst die Konsequenz in einem Satz: „A diff a human can actually read is now a design constraint, not a courtesy.“ Wie sich Review, Freigabe und Merge unter dieser Last neu ordnen lassen, beschreibe ich im Beitrag zu Review und Freigabe von KI-Code.
Willison formuliert den Anspruch an den Einreichenden: „Almost anyone can prompt an LLM to generate a thousand-line patch and submit it for code review. That's no longer valuable. What's valuable is contributing code that is proven to work.“ Wer unbewiesenen Code einreicht, verschiebt die eigentliche Arbeit nur auf den Reviewer.
Auf der anderen Seite steht Peter Steinberger (OpenClaw), im Interview mit The Pragmatic Engineer unter dem Titel „I ship code I don't read“. Seine Absicherung ist eine Schleife, in der Agenten Build, Linter und Tests lokal selbst ausführen und ihr Ergebnis prüfen. Das funktioniert zumindest für ein Solo-Produkt mit einem Entwickler, der jede Entscheidung selbst trägt. Für geteilte oder regulierte Codebasen gilt das aus meiner Sicht nicht. Wer auf Zeilen-Review verzichtet, muss ihn durch stärkere Nachweise ersetzen, nicht durch Vertrauen.
Verifikation muss delegierbar werden
Solange Menschen jeden Agentenbeitrag selbst starten, ausprobieren und nachprüfen, hängt die Verifikation an ihrer Zeit. Strengere Regeln allein reichen deshalb nicht. Die Prüfung muss so ausführbar werden, dass ein Agent sie wiederholen kann. Die gründlichste Ausarbeitung dazu, die ich kenne, ist pstack von Lauren Tan (poteto, Cursor). Dort steht die Definition of Done vor Beginn als widerlegbare Bedingung fest, geprüft wird am echten Artefakt, nicht an der Selbstauskunft. Also nicht „Der CSV-Export funktioniert“, sondern: Der Export der festgelegten Testdaten lässt sich erneut einlesen, enthält alle erwarteten Datensätze und erhält Umlaute und Zeilenumbrüche. Bei einer Abweichung endet der Prüfablauf mit einem Fehler.
Damit ein anderer Agent solche Belege erzeugen kann, beschreibt ein Verifikations-Skill projektspezifisch, wie die App startet, wie die laufende Instanz geprüft wird, wie der echte Ablauf läuft, welche Belege bleiben und wie aufgeräumt wird. Pro Funktion hält er fest, welcher beobachtbare Endzustand beweist, dass sie funktioniert.
pstack kennt beide Enden: Abläufe, die vor dem Merge anhalten, und ausdrücklich delegiertes Mergen, nachdem ein Agent, der den Code nicht geschrieben hat, die Änderung geprüft hat. Welche Variante gilt, entscheidet das Team vorab. Die Verantwortung bleibt bei Menschen, der einzelne Prüfschritt nicht zwingend.
Regeln im Prompt sind Hinweise, keine Durchsetzung
Viele Teams schreiben ihre Definition of Done direkt in AGENTS.md oder CLAUDE.md. Das ist ein guter Ort für Präferenzen und ein schlechter für Pflichten. Die Claude-Code-Doku nennt CLAUDE.md-Anweisungen „advisory“, Hooks dagegen „deterministic“, und warnt, dass in überlangen Dateien Regeln untergehen. Issue #32198 zeigt ja, was das praktisch heißt.
Pflichten gehören deshalb in Hooks und CI, und zwar an drei Stellen:
- Im Agenten-Loop: Ein Stop-Hook führt
make verifyaus und blockiert das Beenden mit Exit-Code 2, solange Checks fehlschlagen. So beschreibt es die Hooks-Referenz von Claude Code (Stand: Oktober 2026). Die Doku begrenzt auch, wie oft ein Stop-Hook hintereinander blockieren darf, danach endet der Turn trotzdem. Eine unabhängig erzwungene Merge-Sperre ersetzt der Stop-Hook deshalb nicht. Hook-Schema und Verhalten prüfen Sie vor dem Einsatz anhand der aktuellen Doku Ihres Werkzeugs. - Vor dem Schreiben: Ein PreToolUse-Hook blockiert Schreibzugriffe auf Akzeptanztests, CI-Konfiguration, Migrationen und Secrets, ebenfalls über Exit-Code 2. Das Orakel gehört nicht dem Agenten. Hooks kontrollieren allerdings nur definierte Werkzeugaufrufe, ein Matcher auf
Edit|Writesieht keinen Schreibzugriff über Bash. Geschützte Prüfmittel brauchen deshalb zusätzlich Zugriffsbeschränkungen über Berechtigungen oder Isolation, die auch solche Schreibwege abdecken. - In der CI, unabhängig vom Agenten: Build, Typecheck, Lint, Tests, E2E-Smoke, Security-Scans, dazu ein Test-Integritäts-Check auf neue
skip,xfailoder.only, gelöschte Testdateien und sinkende Testanzahl, sowie ein PR-Größen-Gate.
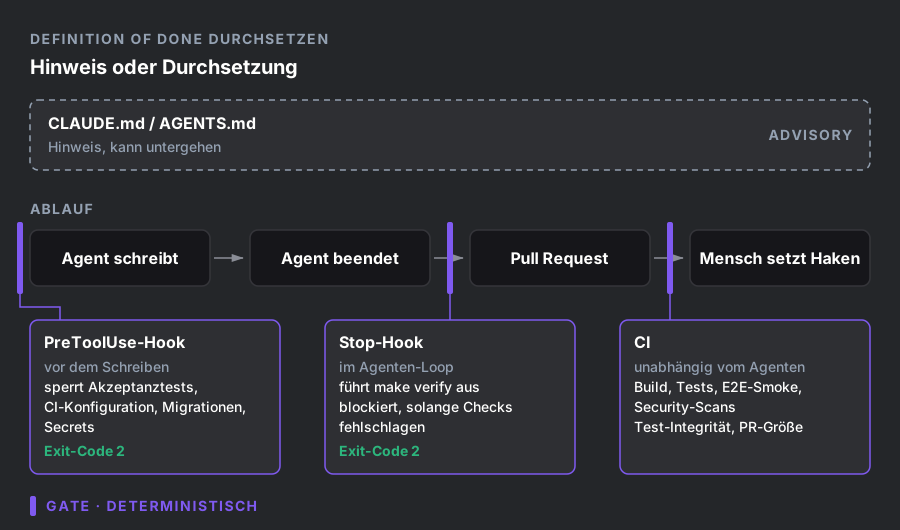
Die Datei mit den Regeln berührt den Ablauf nirgends. Blockieren können nur die drei Gates, jedes an einem anderen Moment. Lückenlos ist das erst mit Berechtigungen und einer Merge-Sperre, die der Agent nicht umgehen kann.
Ein Nachweis zählt nur, wenn er nach dem letzten Edit entstanden und reproduzierbar ist: Befehl, Exit-Code, CI-Lauf, Trace. Genau das wurde in #11913 und #46940 verletzt. Für Oberflächen gehören Screenshots oder Demos dazu. Willison hat dafür mit Showboat und Rodney eigene Werkzeuge gebaut, mit denen Agenten vorführen, was sie gebaut haben.
Die Verantwortung trägt ein Mensch
Beim Thema Verantwortung gehen Open-Source-Projekte schon länger voran. Mitchell Hashimoto verlangt bei Ghostty seit August 2025 die Offenlegung von KI-Nutzung und hat im Januar 2026 nachgeschärft: „This is not an anti-AI stance. This is an anti-idiot stance.“ Die Policy fordert: „The human-in-the-loop must fully understand all code.“ Daniel Stenberg hat am 26. Januar 2026 angekündigt, das Bug-Bounty-Programm von curl zum 31. Januar zu beenden. Als Gründe nennt er KI-Slop, sinkende Qualität auch menschlicher Reports und eine Trefferquote bestätigter Lücken, die seit 2025 unter 5 Prozent liegt (früher über 15 Prozent).
Der Konsens dahinter: Ein Agent kann keine Verantwortung tragen. Menschen verantworten den Qualitätsmaßstab, die Berechtigungen und das akzeptierte Restrisiko, und sie legen vorab fest, welche Prüfungen und Freigaben automatisiert laufen dürfen. Bei hohem Risiko setzt „Done“ ein Mensch, der die Änderung ohne KI erklären kann, mit Wirkung, Wechselwirkungen und Rollback.
Vorsicht auch bei den Zahlen, mit denen Anbieter werben. Cognition meldete im November 2025 für Devin selbst eine PR-Merge-Rate von 67 Prozent nach 34 Prozent im Vorjahr. Merge-Raten messen Akzeptanz, nicht Wert, Korrektheit oder Folgekosten. Sinnvoller ist es, Change-Failure-Rate, Rework- und Revert-Rate, Zeit bis zum ersten Review und Review-Aufwand pro PR nachzuhalten. Mehr dazu steht im Beitrag zu DORA-Metriken für Coding Agents.
Und eine Unterscheidung, die in der Diskussion ständig verschwimmt: Karpathy hat Vibe Coding ausdrücklich für „throwaway weekend projects“ beschrieben. Anfang Februar 2026, ein Jahr später, schlug er „agentic engineering“ als Begriff für die professionelle Arbeit mit Agenten vor: mehr Aufsicht, mehr Prüfung und das Ziel, möglichst viel aus den Agenten herauszuholen, „without any compromise on the quality of the software“ (zitiert nach The New Stack). Für Prototypen darf „Done“ schon heißen: läuft in der Demo. Für Produktionscode braucht es die volle Definition of Done. Wo die Grenze verläuft, habe ich im Beitrag zu Vibe Coding und Produktion beschrieben.
Checkliste: Definition of Done für Agentenarbeit
Die Kurzfassung zum Abhaken. Die Zusammenfassung, die der Agent am Ende schreibt, zählt dabei für keinen einzigen Punkt als Nachweis.
Vor dem Start
- Ziel, Out of Scope und betroffene Module sind schriftlich festgehalten
- Akzeptanzkriterien sind widerlegbar formuliert (Given / When / Then), und für jedes ist festgelegt, wie es geprüft wird
- Ein menschlicher Owner und eine Risikoklasse sind benannt, und es ist festgelegt, was automatisiert freigegeben werden darf
Nachweise im PR
- Befehle mit Exit-Code und Ausgabe, ausgeführt nach dem letzten Edit
- UI: Screenshot, Video oder Trace des echten Flows
- Backend: Nachweis am laufenden Service, nicht nur Mocks
- Liste „Nicht verifiziert“, jeder Punkt geprüft oder bewusst akzeptiert
- KI-Nutzung offengelegt
Integrität der Tests
- Keine Tests gelöscht, übersprungen oder abgeschwächt, oder begründet und von einem Menschen freigegeben
- Bei Bugfixes reproduziert ein Regressionstest den ursprünglichen Fehler (rot → grün), bei anderen Änderungen ist die Aussagekraft neuer Tests passend nachgewiesen
- Geschützte Akzeptanztests unverändert
Gates und Review
- CI grün inklusive E2E-Smoke und Security-Scans
- PR klein genug für ein echtes Review (Richtwert ≤ ~400 Zeilen Logik, ein Anliegen)
- Reviewer hat den Diff gelesen, nicht nur die Zusammenfassung
- Bei hohem Risiko zweites menschliches Review
Abschluss
- „Done“ setzt ein Mensch oder ein vorab festgelegter Ablauf nach unabhängiger Prüfung, nie der arbeitende Agent selbst, bei hohem Risiko immer ein Mensch
- Nach dem Deployment kurz verifiziert (Smoke-Check, Metrik, Fehlerrate)
Was ich Engineering-Leads mitgebe
- Belegt statt behauptet. Jede Fertigmeldung braucht Befehl, Exit-Code und Ausgabe nach dem letzten Edit.
- Das Orakel gehört nicht dem Agenten. Akzeptanztests, CI-Konfiguration und Hooks liegen außerhalb dessen, was er unbemerkt ändern darf.
- Wer arbeitet, bewertet nicht. Geprüft wird unabhängig: CI, ein zweiter Agent in frischem Kontext, ein Mensch.
- Klein schneiden und risikobasiert prüfen. Vorab festlegen, was nach unabhängiger Prüfung automatisiert durchgehen darf. Auth, Zahlungen, Daten und Infrastruktur doppelt prüfen, mit menschlichem Haken.
- Jede falsche Fertigmeldung ist ein Vorfall. Die Antwort darauf ist nicht reflexhaft ein neuer Hook, sondern eine Kontrolle an der frühesten Stelle, die trägt: zuerst Architektur, dann Typen oder ein Lint- bzw. CI-Check, dann Tests, Doku und Prompt-Regeln zuletzt. Ob die Kontrolle greift, zeigt erst ihr Test am tatsächlich aufgetretenen Fehler (pstack: correct).
- Review-Kapazität planen. Die Parallelität der Agenten richtet sich nach der menschlichen Prüfkapazität, nicht umgekehrt.
Zurück zu Issue #32198
Die CLAUDE.md in Issue #32198 war nicht schlecht formuliert. Sie stand nur an der falschen Stelle. Kurzum: Eine Definition of Done, die der Agent überspringen kann, ist eine Bitte. Erst wenn Hooks, geschützte Tests und eine unabhängige CI sie durchsetzen und Menschen vorab festlegen, wer oder was den Haken setzen darf, wird daraus wieder das, was sie in Scrum immer sein sollte: eine Zusage des Teams.
Welche Punkte Ihrer Definition of Done heute nur im Prompt stehen und welche wirklich durchgesetzt werden, lässt sich meist ziemlich schnell eingrenzen. Ob sich ein genauerer Blick für Ihr Team lohnt, klären wir in einem 15-minütigen Erstgespräch. Sprechen Sie mich an.
Quellen
- Anthropic: Claude Code Docs, „Best practices“, code.claude.com, abgerufen am 15. Oktober 2026.
- Anthropic: Claude Code Docs, „Hooks reference“, code.claude.com, abgerufen am 15. Oktober 2026.
- Claude-Code-Issues auf GitHub: #11913 (19. November 2025), #32198 (8. März 2026), #33781 (12. März 2026), #46940 (12. April 2026), #56870 (7. Mai 2026).
- METR: „Many SWE-bench-Passing PRs Would Not Be Merged into Main“, metr.org, 10. März 2026.
- METR: „Recent Frontier Models Are Reward Hacking“, metr.org, 5. Juni 2025.
- Kent Beck: „Genie Wants to Leap“, newsletter.kentbeck.com, 12. Mai 2025.
- Kent Beck: „Augmented Coding Technique: Copy From Simpler Language“, newsletter.kentbeck.com, 6. Juni 2025.
- Simon Willison: „Your job is to deliver code you have proven to work“, simonwillison.net, 18. Dezember 2025.
- Simon Willison: „Introducing Showboat and Rodney, so agents can demo what they've built“, simonwillison.net, 10. Februar 2026.
- Boris Cherny: Setup-Thread, threads.com/@boris_cherny, 2. Januar 2026, und Opus-4.7-Tipps, threads.com/@boris_cherny, 16. April 2026.
- Addy Osmani: „Agentic Code Review“, addyosmani.com, 15. Juni 2026.
- Faros AI: „The AI Productivity Paradox Report 2025“, faros.ai, 23. Juli 2025.
- Johannes Barop (codecentric): „The Bottleneck in the AI Coding Loop“, codecentric.de, 8. September 2026.
- Gergely Orosz (The Pragmatic Engineer): „The creator of Clawd: ‚I ship code I don't read‘“, newsletter.pragmaticengineer.com, 28. Januar 2026.
- Ghostty: PR #8289 (19. August 2025), PR #10412 (22. Januar 2026), AI_POLICY.md.
- Daniel Stenberg: „The end of the curl bug-bounty“, daniel.haxx.se, 26. Januar 2026.
- Cognition: „Devin's 2025 Performance Review: Learnings From 18 Months of Agents At Work“, cognition.com, 14. November 2025.
- Andrej Karpathy: „Vibe Coding“, 2. Februar 2025, zitiert nach Simon Willison, simonwillison.net.
- Andrej Karpathy: „agentic engineering“, Februar 2026, zitiert nach Darryl K. Taft, The New Stack, thenewstack.io, 10. Februar 2026.
- Ken Schwaber, Jeff Sutherland: „The Scrum Guide“, scrumguides.org, November 2020.
- Lauren Tan (poteto): pstack, README, Guide „Verify and ship“, Skills figure-it-out, principle-prove-it-works, create-verification-skill, correct und Playbook shipping, abgerufen am 15. Oktober 2026.
- Laimonade: „Definition of done when an agent wrote the code“, laimonade.com, 1. September 2026.
Stand: 15. Oktober 2026. Aussagen zu Hooks und zur Claude-Code-Dokumentation geben den Stand dieses Datums wieder.