
Streicht man aus einem Bug-Report die Hinweise auf die zu ändernden Dateien, schreiben Coding Agents in den meisten gescheiterten Läufen weiterhin korrekten Code, allerdings in die falsche Datei. Das zeigt eine Studie von Khatib et al. (Preprint, 2026). Ohne Dateiverweise sank die Lösungsrate um 29 bis 40 Prozentpunkte, ohne Anforderungen um 55 bis 65. Die Autoren beschreiben ein Muster: Der Agent legt sich auf eine plausible Lesart fest und setzt sie um, „the agent does not stop to ask“.
Die Zahlen sind groß, aber eng gemessen. Getestet wurden zwei offene Modelle an Aufgaben aus SWE-bench Pro, die das jeweilige Modell mit vollständiger Beschreibung zuvor mindestens einmal in drei Versuchen gelöst hatte. Die Ausgangsrate liegt damit konstruktionsbedingt bei 100 Prozent. Die gestrichenen Anforderungen stammen zudem teils aus nachträglichen Ergänzungen des Benchmarks, nicht aus den ursprünglichen Issues. Die Studie zeigt also, was Lücken bei an sich lösbaren Aufgaben kosten. Den Nutzen einer DoR im Team misst sie nicht.
Im Beitrag zur Definition of Done ging es um das Ende eines Agentenlaufs: Agenten melden „fertig“, sobald ihr eigenes Signal grün ist. Die andere Hälfte des Problems liegt am Anfang: Teams verlassen sich darauf, dass der Agent nachfragt, wenn etwas unklar ist. Heraus kommt ein sauberer Pull Request für das falsche Problem, mit grünen Tests. Für diese Lücke lohnt es sich, die Definition of Ready wieder hervorzuholen.
Kurz gefasst: Die Definition of Ready (DoR) legt fest, wann ein Ticket so weit geklärt ist, dass jemand es übernehmen kann. Bei Agentenarbeit lautet die Frage: Kann der Agent die Aufgabe umsetzen, ohne ungeklärte fachliche Entscheidungen selbst treffen zu müssen? Und steht vorher das Orakel fest, also der Maßstab, an dem wir erkennen, ob das Ergebnis fachlich richtig ist? Die DoR hält kein Ticket auf. Sie begrenzt, wann ein Agent es autonom umsetzen darf. Unklare Tickets gehen in den Explore-Modus und werden dort geklärt. Die DoR legt das Orakel fest, die DoD prüft es.
Auf Rückfragen von Agenten ist kein Verlass
Die Forschung ist jung und arbeitet meist mit simulierten Nutzern. Sie zeigt nicht, dass Agenten nie nachfragen, sondern dass man sich nicht darauf verlassen kann. In Ambig-SWE (ICLR 2026) konnten die meisten Modelle schlecht unterscheiden, ob eine Aufgabe ausreichend spezifiziert war. Ob sie nachfragten, hing vom Modell ab und davon, ob man sie zur Interaktion aufforderte. Taten sie es, verbesserten sich die Ergebnisse um bis zu 74 Prozent. In „Ask or Assume?“ (EMNLP 2026) erreichte ein einzelner Agent mit selbst gesteuerten Rückfragen 61,2 Prozent gegenüber 70,8 Prozent mit vollständigem Issue. Ein System mit separatem Agenten, der fehlende Angaben erkennt, kam dagegen auf 69,4 Prozent. Rückfragen können die Lücke also weitgehend schließen. Ihr Nutzen hängt aber davon ab, wie das System sie organisiert.
Meine Empfehlung: Teams sollten fachliche Klärung bewusst organisieren, statt sie dem spontanen Rückfrageverhalten eines Agenten zu überlassen. Einfach in den Lauf verlagern lässt sie sich nicht. Laban et al. zeigen bei 15 Modellen: Wird eine Anweisung über mehrere Runden verteilt statt vollständig gegeben, sinkt die Leistung im Mittel um 39 Prozent. Untersucht wurden Einzelaufgaben, keine Repo-Agenten. Die Empfehlung der Autoren passt trotzdem: Anforderungen konsolidieren und neu starten.
Birgitta Böckeler fasst die Konsequenz zusammen: „Correctness is outside any sensor's remit if the human didn't clearly specify what they wanted in the first place.“ Der Engpass kann also nach vorn wandern, zu unklaren Anforderungen und offenen Entscheidungen, wie schon im Beitrag zu Background Agents beschrieben. Die DoR kann diese Klärung verbindlich machen.
Präzision zählt, nicht bloß Textmenge
Bei Khatib et al. wirkte Präzision, nicht Umfang:
| Im Ticket | Befund | Evidenz |
|---|---|---|
| Anforderungen | Entfernen kostet 55–65 Prozentpunkte | Ablation, zwei offene Modelle, SWE-bench Pro |
| Dateiverweise | Entfernen kostet 29–40 Punkte, korrekter Code landet in der falschen Datei | Ablation, wie oben |
| Struktur | Listen glätten oder Überschriften entfernen kostet rund 10–30 Punkte, ohne Inhaltsverlust | Ablation, wie oben |
| Reproduktionsskript | Odds Ratio 2,52, Reproduktionsschritte in Prosa: kein Zusammenhang | beobachtend, 433 Issues, nicht kausal |
| Fehlerinformation | größter Einfluss auf den Erfolg (Tendenz) | „Asking What Matters“, ein offenes Modell, simulierter Nutzer |
| Länge | längere Reports, weniger Erfolg (Odds Ratio 0,49) | beobachtend, Länge kann Komplexität widerspiegeln |
Mehr Text ist nicht automatisch mehr Klarheit. François Zaninotto beschreibt, wie Spec Kit acht Dateien und rund 1.300 Zeilen erzeugte, um das aktuelle Datum anzuzeigen, und der Agent „verify implementation“ ohne Tests abhakte.
Akzeptanzkriterien sind erst ready, wenn ihr Prüfweg feststeht
Given/When/Then oder EARS („WHEN … THE SYSTEM SHALL …“) sind Formate, kein Ziel. Für Agenten ist ein Kriterium erst dann ready, wenn feststeht, womit es geprüft wird: Testname, Befehl, Szenario oder Messwert.
Dazu gehört eine Baseline, die in kaum einer klassischen DoR steht: Läuft die bestehende relevante Testsuite heute in der Agentenumgebung, und ist ihr Ergebnis auf main dokumentiert? Schlägt sie fehl, ohne dass jemand weiß warum, kann der Agent das Orakel nicht von Altlasten unterscheiden. Dann besteht das Risiko, dass er den Prüfmaßstab umdeutet. Ein neuer Test, der den Fehler nachweist, darf vor der Korrektur dagegen fehlschlagen. Dafür ist er da.
Wer das Orakel festlegt, ist die eigentliche Führungsfrage. Böckeler hat in einer kleinen explorativen Auswertung untersucht, ob TDD im Agenten-Loop hilft: kein klarer Qualitätsvorteil, dafür etwa drei- bis achtfacher Tokenverbrauch. Ein roter Test beweist nur dann etwas, „if someone is checking why it went red“. Naresh Jain kommt von der Harness-Seite zum selben Schluss: „The checks can enforce only the expectations humans encode.“ Was zählt: Ein Mensch legt das Orakel vor dem Lauf fest oder nimmt es ab.
Meine Empfehlung zur Zuständigkeit: Die Fachseite verantwortet Absicht und Nicht-Ziele, Engineering übersetzt sie im Refinement in Prüfwege und nimmt neue Tests ab. Kriterien, die sich nicht automatisieren lassen, etwa UX oder fachliche Angemessenheit, werden als manuell markiert, mit benannter Prüfperson. Auch damit ist der Prüfweg festgelegt.
Readiness betrifft Ticket, Repo und Umgebung
Ein perfektes Ticket in einem nicht agentenfähigen Repo ist nicht ready. OpenAI schreibt über ein internes Greenfield-Projekt, es sei anfangs langsam vorangegangen, „because the environment was underspecified“. Daraus folgen drei Ebenen:
- Ticket, pro Aufgabe: Ziel, Nicht-Ziele, Kriterien mit Prüfweg, Einstiegspunkte im Code.
- Repo, einmal herstellen und regelmäßig prüfen: aktuelle
AGENTS.mdoderCLAUDE.mdmit Build-, Test- und Lint-Befehlen, Struktur und Grenzen nach Always / Ask first / Never, auffindbare ADRs. - Umgebung: reproduzierbares Setup (etwa
copilot-setup-steps.yml, Devcontainer,init.sh), Build und relevante Tests in vertretbarer Zeit, verwertbare Fehlermeldungen.
Gerade in Altsystemen gilt Böckelers Satz: „the harness is most needed where it is hardest to build.“
Risiko und Rechte entscheiden über den Modus
Die DoR legt auch fest, in welchem Modus ein Agent arbeiten darf. Ich unterscheide vier:
| Modus | Voraussetzung | Was der Agent darf |
|---|---|---|
| Explore | Ziel oder Orakel noch unklar | analysieren, Fragen stellen, Plan oder Prototyp liefern, kein Merge |
| Plan-then-execute | Orakel steht, mittleres Risiko oder größerer Umfang | Plan vorlegen, nach menschlicher Freigabe umsetzen |
| Execute | Orakel, geprüfte Baseline, niedriges Risiko, Rechte in der Standard-Sandbox oder einer freigegebenen Erweiterung | autonom bis zum Pull Request |
| Nicht delegieren | kritisch, sensibel oder nicht prüfbar | allenfalls Explore |
GitHub rät in der Copilot-Dokumentation selbst davon ab, unter anderem produktionskritische, sicherheitsrelevante und mehrdeutige Aufgaben zu delegieren. Ich würde irreversible Migrationen auf geteilten Datenbeständen ergänzen.
Rechte gehören in dieselbe Prüfung. Simon Willison empfiehlt für agentische Schleifen eine Sandbox und eng begrenzte Credentials mit Budgetlimit. Braucht ein Ticket Rechte außerhalb der Standard-Sandbox, etwa Secrets, zusätzliche Netzwerkziele oder Migrationen auf geteilten Datenbanken, ist es erst ready für Execute, wenn eine Freigabe dokumentiert ist. Die übrigen Bedingungen hebt diese Freigabe nicht auf: Das Risiko muss weiterhin zum Modus passen.
Ein Beispiel: vom Ticket zum Modus
Ein ausgedachtes, aber typisches Ticket: „CSV-Export zeigt Umlaute falsch an, bitte fixen.“
Ein Agent könnte sofort loslegen. Er müsste dabei aber selbst entscheiden, was „richtig“ heißt: UTF-8 mit BOM, damit Excel unter Windows die Datei korrekt öffnet, oder Windows-1252, weil ein Import-Skript beim Kunden genau das erwartet? Das ist keine Frage der Umsetzung, sondern eine fachliche. Also Explore: Der Agent sucht im Repo, wer den Export verarbeitet, und legt die Optionen mit ihren Folgen vor. Gemergt wird nichts.
Nach der Entscheidung durch die Fachseite sieht das Ticket so aus:
- Ziel: Exportierte CSV-Dateien öffnen sich in Excel unter Windows mit korrekten Umlauten.
- Nicht-Ziel: Spalten, Reihenfolge und Trennzeichen bleiben unverändert.
- Kriterium: Given ein Kunde „Müller & Söhne“, When der Export läuft, Then beginnt die Datei mit einem UTF-8-BOM und enthält „Müller“ korrekt kodiert. Prüfweg: neuer Test
tests/export/test_csv_encoding.py, von einem Menschen abgenommen. - Manuell: Öffnen in Excel unter Windows, Prüfperson benannt.
- Baseline: bestehende Export-Tests grün auf
main, der neue Test schlägt vor der Korrektur erwartungsgemäß fehl. - Risiko und Rechte: niedrig, Standard-Sandbox. Modus: Execute.
Offen bleiben darf, in welcher Funktion der Agent die Änderung vornimmt und wie er sie strukturiert. Das ist Umsetzung. Geklärt sein muss, welche Kodierung gilt und woran man erkennt, dass sie stimmt. Das ist das Orakel.
Plan-Modus und Interview stellen die DoR her, sie ersetzen sie nicht
Die Werkzeuge haben Klärung längst eingebaut (Stand: Oktober 2026). Claude Code empfiehlt laut Doku, sich vom Agenten interviewen zu lassen, das Ergebnis in einer SPEC.md festzuhalten und die Umsetzung in einer neuen Session zu starten. Atlassian wendet ein, mit erkennbarem Eigeninteresse: Plan-Modi entwerfen das „Wie“, ohne dass ein vereinbartes „Was“ dahintersteht.
Beides lässt sich verbinden, ein Plan, den niemand gelesen hat, ist allerdings keine DoR. Aus Klärung wird erst Readiness, wenn ein Mensch die Fragen beantwortet und abnimmt, das Ergebnis als Artefakt im Ticket oder in der SPEC.md landet und die Umsetzung in frischem Kontext beginnt. Die Arbeitsteilung: Der Agent klärt Repo-Fakten und schlägt Kriterien vor, ein Mensch entscheidet über Ziel, Nicht-Ziele, Orakel, Risiko und Rechte. Aus den Three Amigos, dem klassischen Refinement-Trio aus Fachseite, Entwicklung und Test, werden drei Amigos plus Agent.
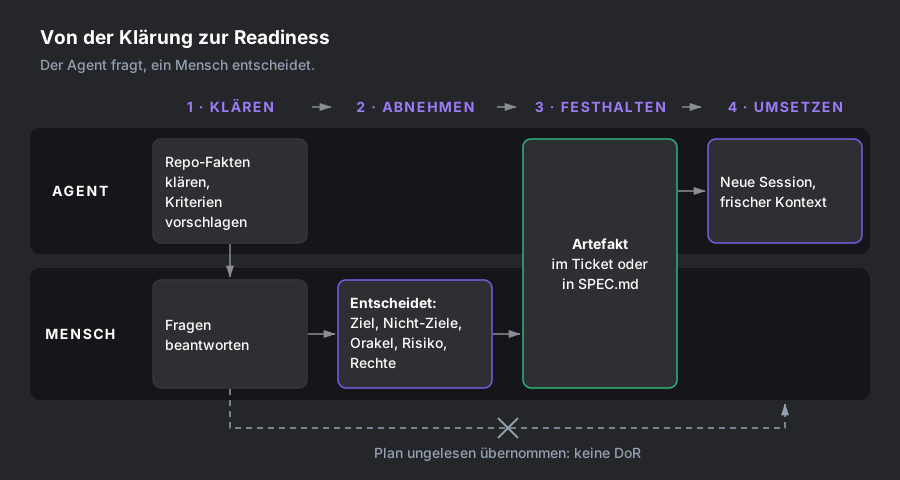
Readiness entsteht erst mit der Abnahme durch einen Menschen und einem festgehaltenen Artefakt. Ein Plan, den niemand gelesen hat, überspringt genau diesen Schritt.
Warum die Definition of Ready umstritten ist
Der Scrum Guide 2020 kennt keine Definition of Ready, nur Einträge, die nach dem Refinement „ready for selection“ sind. Mike Cohn rät den meisten Teams ausdrücklich davon ab. Seine Sorge: Eine DoR wird schnell zum Gate und damit zum Schritt Richtung Stage-Gate. Selbst Funs Janssen, der blockierende Statusübergänge befürwortet, beschreibt das Gegenbild: „a team adds forty checklist items … everyone is checking boxes reflexively“.
Das stärkste Argument gegen die DoR lautete: Unklarheit klärt man im Gespräch. Das setzt voraus, dass die Person, die umsetzt, nachfragt. Janssen hält dagegen: „An AI agent does not pause.“ Die Schutzschranke müsse deshalb beim Work Item ansetzen. Auf seiner Seite stehen vor allem Werkzeughersteller wie Atlassian, BMAD und Factory.
Mir ist keine Studie bekannt, die Teams mit und ohne DoR für Agenten vergleicht. Meine eigene Einordnung, gestützt auf Plausibilität und indirekte Evidenz:
- Das Gate steht vor der Ausführung, nicht vor der Arbeit. Es prüft Delegierbarkeit, nicht Vollständigkeit: Kann der Agent umsetzen, ohne fachliche Entscheidungen selbst zu treffen, und können wir das Ergebnis prüfen?
- Zwei Ready-Zustände. Ready to explore braucht nur Owner, offene Frage und erwartetes Klärungsergebnis. Ready to execute verlangt Orakel, Baseline, Risikoklasse und geklärte Rechte. Unklare Tickets werden erkundet statt abgelehnt. Damit ist Cohns Einwand ernst genommen.
- Harte Kriterien sperren nur Execute. Sechs blockierende Punkte, alles andere sind Leitlinien.
- Gewicht nach Größe und Risiko. Die Claude-Code-Doku formuliert es knapp: „If you could describe the diff in one sentence, skip the plan.“ Auch Atlassian hält bei kleinen, umkehrbaren Änderungen einen guten Prompt oft für ausreichend.
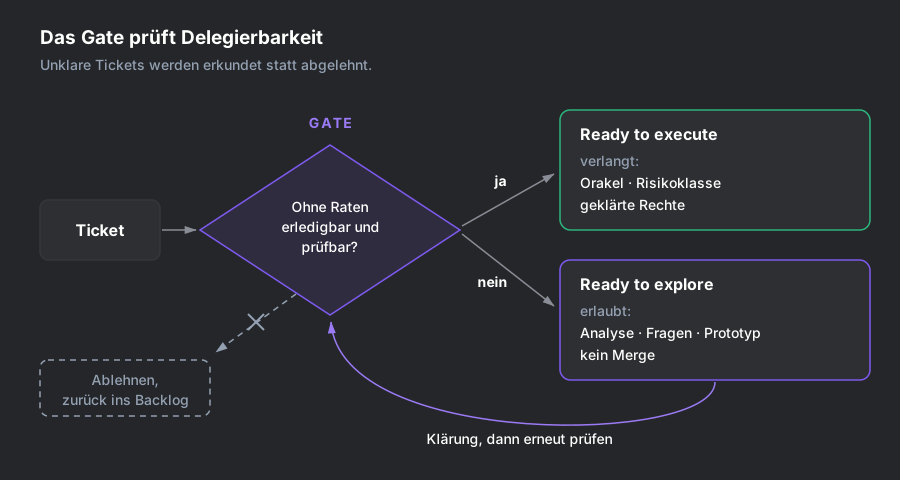
Das Gate sortiert Tickets in zwei Arbeitsmodi statt in angenommen und abgelehnt. Der Weg zurück ins Backlog ist gestrichen.
In den Werkzeugen ist die DoR ohnehin angekommen (Stand: Oktober 2026). Startet in Jira ein Agent, sobald eine Karte in eine bestimmte Spalte rutscht, ist die Spalte die DoR. Linear trennt laut Doku Delegate und Assignee: Der Agent führt aus, der Mensch bleibt verantwortlich.
Die DoR schreibt das Orakel, die DoD prüft es
Der DoD-Artikel ließ offen, wann die widerlegbare Bedingung entsteht, an der ein Ergebnis gemessen wird. Sie entsteht in der DoR, wie im Beispiel oben. Die eine legt die Bedingung vor dem Lauf fest, die andere prüft sie danach. Genauer: Die DoR verlangt, dass die aufgabenspezifischen Akzeptanzkriterien und ihre Prüfwege feststehen. Die DoD enthält darüber hinaus die gemeinsamen Qualitätsanforderungen an das Ergebnis, die für jede Aufgabe gelten.
Als Formel: DoR = Orakel + Grenzen + Modus. DoD = Orakel erfüllt + Belege + Freigabe. „Belegt statt behauptet“ funktioniert nur, wenn vorher feststand, was zu belegen ist. Sonst belegt der Agent eben, was er gebaut hat, nicht, was gewollt war. Das Scharnier ist das Berichtsformat: Die DoR legt fest, welche Belege der Agent im Pull Request liefert, die DoD prüft, ob sie vorliegen.
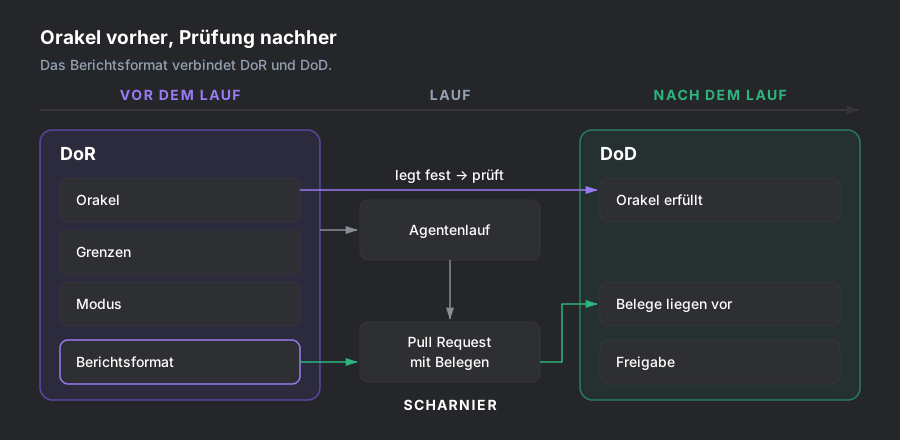
Vorab festgelegte Prüfmaßstäbe machen die fachliche Abnahme nachvollziehbar, die gemeinsamen Qualitätsanforderungen der DoD gelten zusätzlich. Das Berichtsformat sorgt dafür, dass die Belege im Pull Request zu dieser Festlegung passen.
Checkliste: Definition of Ready für Agentenarbeit
Ein Beispiel zum Anpassen an das eigene Team:
Für Explore genügen: menschliche:r Owner, offene Frage, erwartetes Klärungsergebnis, Grenzen und Rechte.
Harte Kriterien für Execute (bei Plan-then-execute spätestens mit der Planfreigabe. Fällt eines durch, bleibt das Ticket in Explore)
- Modus gewählt, menschliche:r Owner benannt, Agent nur Delegate
- Ziel in einem Satz als beobachtbares Ergebnis, mindestens ein Nicht-Ziel
- Akzeptanzkriterien mit Prüfweg je Kriterium (Test, Befehl, Szenario), manuelle Kriterien mit Prüfperson
- Baseline: bestehende relevante Tests laufen in der Agentenumgebung, Ergebnis auf
maindokumentiert - Risikoklasse gesetzt und passend zum Modus, Rechte innerhalb der Standard-Sandbox oder einer ausdrücklich freigegebenen Erweiterung
- Stop-and-ask-Regel und Berichtsformat für den PR festgelegt
Leitlinien
- Ergebnis mit einem Orakel in einem Review beurteilbar, sonst zerlegen
- Einstiegspunkte im Code benannt (Dateien, Module, Schnittstellen)
- Bei Bugs: Fehlermeldung oder Stacktrace plus ausführbare Reproduktion, nicht nur Prosa
- Neue Tests von einem Menschen geschrieben oder abgenommen, Orakel gegen Änderung geschützt
- Vorab-Klärung im Ticket oder in
SPEC.mdkonsolidiert, Umsetzung in neuem Kontext - Repo-Readiness aktuell: Agenten-Instruktionen, Setup, ADRs
Als Vorlage für Issue-Template, Jira-Work-Item oder GitHub Issue Form (● = Pflicht in jedem Modus, ◆ = Pflicht vor Execute, ○ = Pflicht nur für Explore):
## Modus ●
[ ] Explore (kein Merge)  [ ] Plan-then-execute  [ ] Execute
Owner (Mensch): @…   Delegate (Agent): …   Risikoklasse ●: niedrig | mittel | hoch

## Offene Frage ○
<Welche fachliche Entscheidung fehlt?>
Erwartetes Klärungsergebnis: <Optionen mit Folgen | Empfehlung | Prototyp>

## Ziel ◆
<Ein Satz, beobachtbares Ergebnis>

## Nicht-Ziele ◆
- <Was ausdrücklich nicht geändert wird>

## Akzeptanzkriterien ◆
| # | Kriterium (Given/When/Then oder EARS) | Prüfweg | maschinell / manuell (wer) |
|---|---|---|---|
| 1 | Given … When … Then … | `pytest tests/test_x.py::test_y` | maschinell |
| 2 | … | Sichtprüfung durch @… | manuell |
Baseline ◆: `<Prüfbefehl>` auf main, Ergebnis vom … (neue Fehlernachweise dürfen fehlschlagen)

## Lokalisierung
- Einstiegspunkte: `src/…`   Nicht anfassen: `…`
- Nur bei Bugs: Fehlermeldung, Reproduktion `<Skript/Test>`, erwartet vs. tatsächlich

## Grenzen und Rechte ●
- Sandbox: Standard | erweitert (Freigabe: @…, Datum)
- Ask first: Migrationen, neue Abhängigkeiten, CI/Secrets
- Änderungsbudget: max. <n> Dateien / <n> Zeilen, darüber stoppen und melden

## Stop-and-ask ●
- Explore: offene Anforderungen untersuchen, Fragen und Optionen vorlegen, keine fachliche Entscheidung selbst festlegen.
- Umsetzung: neue fachliche Unklarheit → betroffene Änderung pausieren, Entscheidung anfordern.
- Immer: ohne erforderliche Rechte keine entsprechende Aktion.

## Berichtsformat im PR ◆
Je Kriterium Prüfbefehl + Ergebnis · Annahmen · Abweichungen vom Plan · offene Punkte
Drei Entscheidungen für Engineering-Leads
- Wo die DoR steht. Die Vorlage gehört dorthin, wo Tickets entstehen: Issue-Template, Pflichtfelder, Übergangsregeln. Löst eine Board-Spalte den Agenten aus, ist sie Ihre DoR.
- Wer das Orakel festlegt. Die Fachseite verantwortet Absicht und Nicht-Ziele, Engineering Prüfweg und Abnahme neuer Tests. Ein Kriterium ohne Prüfweg ist nicht ready für Execute.
- Was Execute sperrt. Fehlendes Orakel, ungeprüfte Baseline oder Rechte außerhalb der Sandbox führen zu Explore oder zur Freigabe, nicht zur Ablehnung. Stop-and-ask gehört in die Agenten-Guidance, durchsetzen müssen die Grenze aber Rechte und Sandbox. Ob die harten Kriterien die richtigen sind, zeigen Rework-Quote und Review-Funde je Risikoklasse.
Zurück zur falschen Datei
Der Agent aus der Bug-Report-Studie hat eine Lücke im Ticket mit einer plausiblen Annahme gefüllt und sauber umgesetzt. Bei menschlicher Zusammenarbeit kann eine Rückfrage solche Lücken auffangen. Darauf sollte sich ein Team bei einem autonomen Agentenlauf nicht verlassen. Die Antwort muss vorher im Ticket stehen, zusammen mit dem Prüfweg, an dem die DoD später misst, ob „fertig“ wirklich fertig ist.
Wenn Sie eine DoR für Agentenarbeit einführen wollen: In einem 15-minütigen Erstgespräch klären wir, ob Ihr Engpass eher im Ticket, im Repo oder in der Umgebung liegt und ob sich eine Begleitung für Ihr Team lohnt. Sprechen Sie mich an.
Zum Weiterlesen
- Specs als Artefakt: Spec-Driven Development, Spec-Governance im Team, Spec Kit und OpenSpec
- Orakel und Prüfer trennen: Verifier-Harness, Testgenerierung
- Repo-Readiness: Context Engineering, Prompt-Patterns für Enterprise-Codebasen, Legacy-Monolith
- Risiko und Rechte: Layering statt Migration, Agent Identity
- Änderungsbudget als Größenordnung: The Magic Words That Make AI Code Better
- Messen, ob die Kriterien stimmen: DORA-Metriken für Coding Agents
Quellen
- Ken Schwaber, Jeff Sutherland: „The Scrum Guide“, scrumguides.org, November 2020.
- Mike Cohn: „The Dangers of a Definition of Ready“, mountaingoatsoftware.com.
- Khatib, Mathews, Nagappan, Nie, Zimmermann: „What Makes a Good Bug Report for an AI Agent?“, arXiv 2607.07593, Preprint, 2026.
- Vijayvargiya, Zhou, Yerukola, Sap, Neubig: „Ambig-SWE: Interactive Agents to Overcome Underspecificity in Software Engineering“, arXiv 2502.13069, ICLR 2026.
- Vijayvargiya, Viswanathan, Neubig: „Asking What Matters: Reward-Driven Clarification for Software Engineering Tasks“, arXiv 2604.14624, ICML 2026.
- Edwards, Schuster: „Ask or Assume? Uncertainty-Aware Clarification-Seeking in Coding Agents“, arXiv 2603.26233, EMNLP 2026.
- Laban, Hayashi, Zhou, Neville: „LLMs Get Lost In Multi-Turn Conversation“, arXiv 2505.06120, Preprint, 2025.
- Birgitta Böckeler: „Harness engineering for coding agent users“, martinfowler.com, 2. April 2026.
- Birgitta Böckeler: „TDD inside the agent loop – theater or actual value?“, martinfowler.com, August 2026.
- Naresh Jain: „Are Harnesses Worth the Cost?“, martinfowler.com, 13. Oktober 2026. Jain ist Gründer von Specmatic.
- François Zaninotto: „Spec-Driven Development: The Waterfall Strikes Back“, marmelab.com, 12. November 2025.
- Simon Willison: „Designing agentic loops“, simonwillison.net, 30. September 2025.
- Funs Janssen: „Guard AI Development at the Work Item, Not the PR“, fjan.nl, 22. Juni 2026. Janssen ist Autor einer Checklisten-Erweiterung für Azure DevOps.
- BMAD Method: Workflow
bmad-build, github.com/bmad-code-org/BMAD-METHOD, abgerufen im Oktober 2026. - Herstellerangaben:
- Anthropic, Claude Code Docs, „Best practices“, code.claude.com, abgerufen im Oktober 2026
- OpenAI (Ryan Lopopolo), „Harness engineering“, openai.com, 11. Februar 2026
- GitHub Docs, Copilot Cloud Agent, Best Practices
- Linear Docs, Agents in Linear und Assigning issues
- Atlassian, „Spec-driven development in Jira“ und „Collaborate on work items with AI agents“
- Factory Docs, Agent Readiness.
Stand: Oktober 2026. Angaben zu Werkzeugen und Produktfunktionen geben den Stand vom 19. Oktober 2026 wieder.