
Ein Procurement-Komitee entscheidet im März, dass Cloud nicht infrage kommt. Im April rechnet der Engineering Lead zum ersten Mal: acht H100-GPUs, 250.000 bis 420.000 Euro, plus Strom, Kühlung, Betrieb. Im Mai ruft die Rechtsabteilung an und fragt, was ein VPC ist.
Die Frage „On-Premise oder Cloud" wird oft gestellt, als gäbe es nur zwei Optionen. Gibt es nicht. Welche Daten fließen wohin? Wer sieht sie? Was verlangt der Regulator tatsächlich? Auf diese Fragen kommt es an.
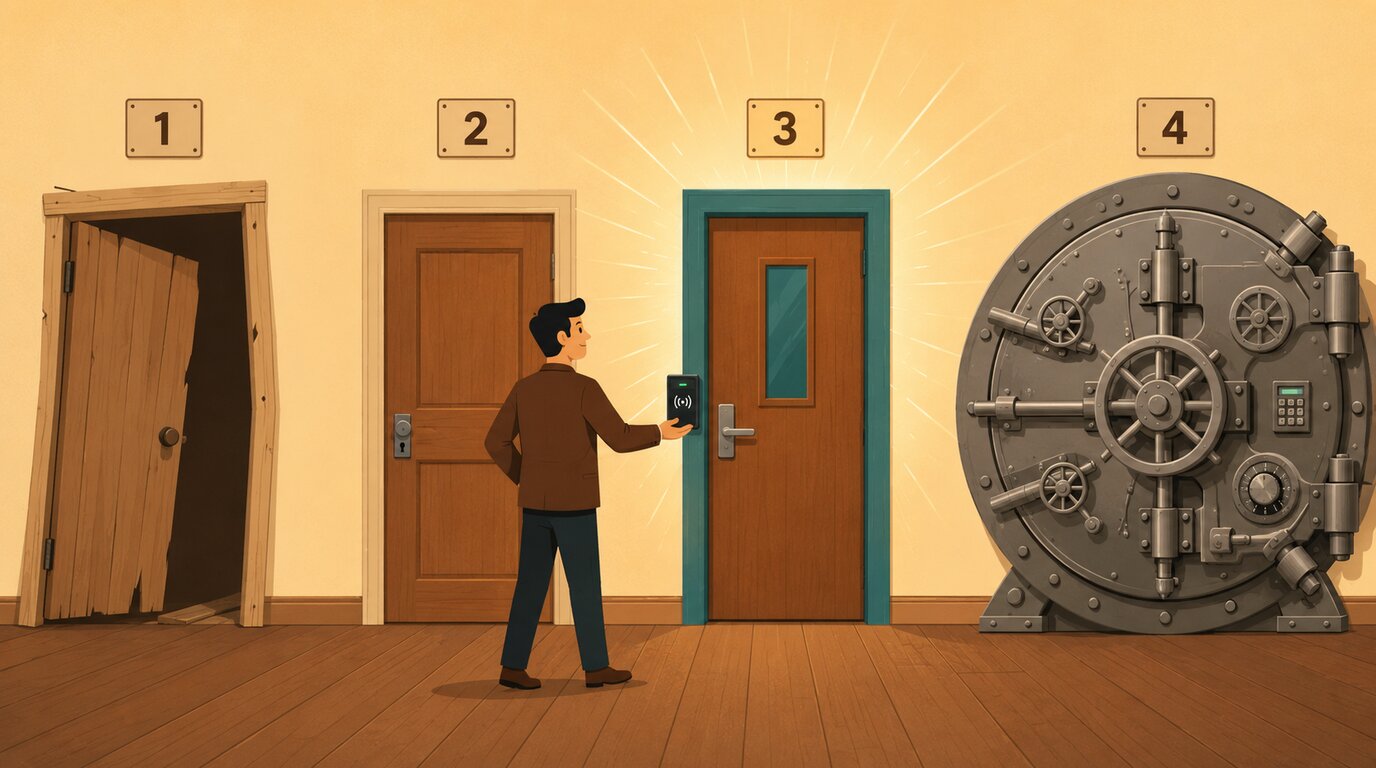
Die vier Stufen
Zwischen öffentlichem SaaS und vollständig air-gapped liegen zwei Zwischenstufen. Sie tauchen in Beschaffungsdiskussionen selten auf, obwohl sie oft die praktikablere Lösung sind.
Stufe 1: Public SaaS. Claude.ai Consumer, ChatGPT Free/Plus, Cursor ohne Enterprise-Vertrag. Bei Public-SaaS muss pro Anbieter und Tarif geprüft werden, ob Eingaben für Training genutzt werden, wie lange Daten gespeichert werden, welche Telemetrie anfällt und welche Datenresidenz zugesichert wird. Enterprise- und Team-Produkte unterscheiden sich hier teils erheblich von Consumer-Tarifen. Für regulierte Codebasen ist diese Stufe meist nur nach genauer Prüfung geeignet.
Stufe 2: Zero-Data-Retention- oder Short-Retention-SaaS. Beispiele sind bestimmte API- oder Enterprise-Konfigurationen bei Anthropic und OpenAI, nicht pauschal jedes Enterprise-Interface. Bei Anthropic gilt ZDR insbesondere für bestimmte Claude-API-Nutzung und für Claude Code über Enterprise, sofern ZDR für die Organisation aktiviert ist. Bei OpenAI sind Zero-Data-Retention-Kontrollen für qualifizierte Organisationen vor allem in der API-Plattform verfügbar. Prompts und Antworten werden dann nicht dauerhaft gespeichert und nicht für Training verwendet, soweit der jeweilige Modus korrekt aktiviert und vertraglich zugesichert ist. Regulatorisch oft ausreichend. Die Nuance: Anthropics ZDR gilt auf deren eigener Plattform. Wer über Bedrock routet, verhandelt mit AWS, nicht mit Anthropic.
Stufe 3: VPC-isoliertes Hyperscaler-Deployment. Claude Code über AWS Bedrock mit VPC-Endpunkten und PrivateLink, Azure OpenAI, Google Vertex AI. Der Datenverkehr bleibt innerhalb der Sicherheitsgrenzen des Cloud-Anbieters. Bei Bedrock konkret: Kundendaten bleiben in der AWS-Infrastruktur, werden nicht an Anthropic weitergegeben und nicht für Training verwendet. Dazu IAM, CloudWatch-Logging, CloudTrail und die Möglichkeit, C5-attestierte Hyperscaler-Services in die Zielarchitektur einzubinden. Für viele Engineering-Teams in regulierten Organisationen dürfte das der praktikable Startpunkt sein, sofern Datenklassifizierung, Drittparteienprüfung und Logging sauber umgesetzt sind.
Stufe 4: Echtes On-Premise oder Air-Gapped. Open-Weight-Modelle aus Familien wie Qwen, DeepSeek, GLM oder MiniMax auf eigener GPU-Infrastruktur, keine Internetverbindung. Wer ein On-Premise-LLM selbst hosten will, braucht nicht nur Hardware, sondern auch MLOps-Kompetenz für Modellbetrieb, Updates und Monitoring. Notwendig für klassifizierte Umgebungen, einige Pharma-R&D-Kontexte, kritische Infrastrukturen. Selten notwendig, wenn das Team ehrlich über seine tatsächlichen regulatorischen Anforderungen nachdenkt.
Viele Organisationen, die „On-Prem" verlangen, meinen Stufe 2 oder 3. Diese Unterscheidung früh zu klären, vermeidet teure Fehlinvestitionen. Der übergeordnete Leitfaden zur Agent-Einführung hilft, die richtige Stufe systematisch zu bestimmen.
Orientierung: Welche Stufe passt?
| Situation | Eher geeignet |
|---|---|
| Keine Kundendaten im Code, normale Repos | Stufe 2 oder 3 |
| Strenge Datenresidenz, Audit-Anforderungen, zentrales IAM | Stufe 3 |
| Klassifizierte Umgebungen, Defense, isolierte R&D | Stufe 4 |
| Experimentelle Nutzung, keine sensiblen Daten | Stufe 1 oder 2 |
| Agent darf Builds ausführen, aber keine Secrets lesen | Stufe 3 mit stark begrenzten Worker-Rechten |
Die Stufe beantwortet nur die Frage, wo Inferenz und Datenfluss stattfinden. Sie beantwortet nicht, welche Rechte der Agent im Repository, Terminal, CI-System oder Cloud-Account erhält. Für Coding-Agents sind Least Privilege, getrennte Service Accounts, Secret-Scoping, Audit Logs und Approval Gates für destruktive Aktionen mindestens so wichtig wie die Hosting-Frage.
Was die Aufsicht wirklich verlangt
Die BaFin hat am 18. Dezember 2025 eine Orientierungshilfe zu IKT-Risiken beim Einsatz von KI veröffentlicht. Die Aufsicht verlangt kein Air-Gap. Sie verlangt Kontrolle über den Datenfluss, Dokumentation, Monitoring, robustes Drittparteienrisikomanagement. Für Finanzdienstleister mit konkreten MaRisk- und DORA-Anforderungen bietet die detaillierte BaFin/MaRisk-Analyse einen tieferen Einstieg.
Cloud-basierte KI-Coding-Werkzeuge dürften in den meisten Konstellationen als IKT-Drittparteienleistung im Sinne von DORA Art. 28 einzuordnen sein. Ob zusätzlich eine Auslagerung nach MaRisk AT 9 vorliegt, hängt von Funktion, Kritikalität und Einbindung in Geschäftsprozesse ab. Das sind juristische Einschätzungen, keine pauschalen Rechtsfeststellungen.
Der KPMG Cloud-Monitor 2025 Financial Services zeigt laut KPMG: 95 Prozent der befragten Finanzunternehmen nutzen bereits LLMs. Die BaFin hat das zur Kenntnis genommen. Die Fokusrisiken 2026 zielen auf das Konzentrationsrisiko bei wenigen großen Cloud-Anbietern, nicht auf Cloud an sich.
In vielen internen Coding-Assistant-Konstellationen wird eher die Nutzung eines GPAI-basierten Systems relevant sein als eine eigene Hochrisiko-Einstufung. Das ändert sich, wenn der Agent in HR-Bewertung, regulierte Entscheidungsprozesse oder als Sicherheitsbauteil in ein Produkt nach Anhang I eingebunden wird. Ein interner Coding-Assistent für das Platform-Team hat ein anderes Risikoprofil als ein KI-System für Kreditentscheidungen.
Allerdings gibt es zwei Sonderfälle: Wenn der Coding-Agent Telemetrie zur Leistungsbewertung von Entwicklern liefert, greift Anhang III Punkt 4. Der zweite: Hochriskant wird der Agent selbst nur, wenn er nach Art. 6 Abs. 1 KI-VO Sicherheitsbauteil eines Produkts nach Anhang I ist (oder selbst ein solches Produkt) und dafür eine Konformitätsbewertung durch Dritte ansteht. Code, den er lediglich zuliefert, erbt keine Klassifikation: Die Pflichten aus Art. 9 bis 15 treffen den Anbieter des Hochrisiko-Systems, nicht das Entwicklungswerkzeug. Wie sich die Rollen verteilen, beschreibt der Beitrag zu den Pflichten aus der KI-Verordnung für Coding Agents im Detail. Nach dem ursprünglichen AI-Act-Zeitplan sollten wesentliche Hochrisiko-Pflichten ab dem 2. August 2026 greifen. Der Digital Omnibus ist als Verordnung (EU) 2026/1744 am 24. Juli 2026 im Amtsblatt veröffentlicht worden und am 27. Juli 2026 in Kraft getreten. Die Pflichten für eigenständige Hochrisiko-Systeme nach Anhang III gelten damit ab dem 2. Dezember 2027, für produktintegrierte Systeme nach Anhang I ab dem 2. August 2028.
Das BSI hat am 27. April 2026 mit C3A einen eigenständigen Souveränitätskatalog als Ergänzung zu C5 veröffentlicht. C5:2026 liefert den aktuellen Kriterienkatalog, C3A den zusätzlichen Souveränitätsrahmen. Ob ein konkreter Hyperscaler-Service ein C5-Testat hat und wie er die C3A-Kriterien erfüllt, muss im Einzelfall geprüft werden. Für private Unternehmen ohne Behörden-, Defence-, KRITIS- oder stark regulierten Kundenkontext ist C3A zunächst eher Bewertungsrahmen als Pflichtprogramm, denn der Katalog ist laut BSI für sich genommen nicht bindend. Für Anbieter, die an Behörden, KRITIS-Betreiber und regulierte Industrien liefern, wird er dagegen beschaffungsrelevant.
Bleibt der Einwand, an dem sich viele Beschaffungsrunden entzünden: AWS, Microsoft und Google sind US-Konzerne oder Teil US-amerikanischer Konzernstrukturen. Der US CLOUD Act von 2018 verpflichtet Anbieter, Daten herauszugeben, die in ihrer „possession, custody, or control" liegen, unabhängig vom physischen Speicherort. Eine EU-Region wie Frankfurt regelt Datenresidenz und Latenz, beseitigt aber nicht automatisch das Drittstaatenzugriffsrisiko. Entscheidend ist, welcher Rechtsträger Vertragspartner ist, wer die technische Kontrolle hat und ob ein US-rechtlich erreichbarer Anbieter Zugriff auf Klartext, Schlüssel oder Betriebsdaten hat. Das ist der eigentliche Grund, warum viele Teams „On-Prem" sagen, und meist der Punkt, den sie nicht laut aussprechen.
Ein VPC-Deployment reduziert dieses Risiko, beseitigt es aber nicht. PrivateLink hält den Netzwerkverkehr innerhalb privater AWS-Verbindungen. KMS, CloudHSM und restriktive Key Policies schützen gespeicherte Artefakte und Logs, soweit Logging, Berechtigungen und Schlüsselmodell korrekt umgesetzt sind. Sie verhindern nicht, dass der Runtime-Service den Prompt zur Inferenz im Klartext verarbeitet. Für nicht-personenbezogene Daten in der EU verlangt Art. 32 Data Act von Anbietern von Datenverarbeitungsdiensten technische, organisatorische und rechtliche Maßnahmen gegen rechtswidrige Drittstaatenzugriffe. Für personenbezogene Daten bleibt die DSGVO-Prüfung daneben erforderlich. AWS gibt Stand Juni 2025 an, seit Beginn der eigenen Statistik 2020 keine Enterprise- oder Government-Customer-Content-Daten, die außerhalb der USA gespeichert waren, an die US-Regierung herausgegeben zu haben. Die AWS European Sovereign Cloud verringert das Risiko durch EU-Betrieb und europäische Governance weiter, ersetzt aber nicht die Einzelfallprüfung von Vertragspartner, technischer Kontrolle, Schlüsselzugriff und Drittstaatenzugriffsrisiko.
Wer Drittstaatenzugriff strukturell außerhalb seines Risikomodells halten muss, landet folgerichtig bei Stufe 4. Wer ein dokumentiertes Restrisiko akzeptieren kann, fährt mit Stufe 3 oft besser: EU-Region, VPC, PrivateLink, restriktives Logging, ein starkes Schlüsselmodell, DORA-, DSGVO- und Data-Act-Unterlagen und ein belastbarer Exit-Plan.
Sprechen Sie mit Ihrer Rechtsabteilung, bevor Sie mit dem Procurement sprechen. Viele „das geht nicht"-Entscheidungen basieren auf Vermutungen, nicht auf Gesetzestexten. In den Procurement-Runden, in denen ich sitze, kippt die harte On-Prem-Forderung häufig an derselben Stelle: Sobald jemand die Datenklassifizierung tatsächlich aufmacht, schrumpft die Menge wirklich schützenswerter Repositories deutlich.
Gehen Sie deshalb nicht mit einer Frage in dieses Gespräch, sondern mit Unterlagen: der Datenklassifizierung des betroffenen Repositories (welche Kategorie personenbezogener oder geschäftskritischer Daten liegt überhaupt im Code?), der Einordnung des Dienstes als IKT-Drittparteienleistung (bei Finanzunternehmen im DORA-Scope inklusive Register-of-Information-Eintrag nach Art. 28 Abs. 3 DORA), dem Nachweis der technischen und organisatorischen Maßnahmen und, sofern personenbezogene Daten betroffen sind, dem Auftragsverarbeitungsvertrag samt Subprozessorliste. Kommt ein Drittlandtransfer hinzu, gehören Standardvertragsklauseln und ein Transfer Impact Assessment dazu. Wer mit diesen Unterlagen kommt, verwandelt eine Grundsatzdebatte in eine Prüfung. Ein pauschales „Cloud geht bei uns nicht" hält ihr selten stand.
Warum das Modell nicht mehr die ganze Antwort ist
Die Modell-Lücke ist bei Coding-Benchmarks kleiner geworden. Als Messlatte taugt SWE-bench Verified dafür nicht mehr: OpenAI weist für den Benchmark seit dem 23. Februar 2026 keine Werte mehr aus, weil Modelle Lösungen aus ihren Trainingsdaten reproduzieren und ein erheblicher Teil der Tests fehlerhaft ist, und empfiehlt stattdessen SWE-bench Pro. Dort liegen starke Open-Weight-Modelle wie GLM-5.1, Kimi K2.6, GLM-5.2 oder Qwen3.8 laut Herstellerangaben bei etwa 58 bis 62 Prozent (Stand: Oktober 2026, Leaderboard-Übersicht). Das ist das Niveau, das GPT-5.5 dort erreicht. Die führenden proprietären Modelle melden allerdings deutlich höhere Werte. Auch an der Bewertung von Pro gibt es inzwischen Kritik, und fast alle Zahlen stammen von den Anbietern selbst, mit unterschiedlichen Harnesses und Budgets. Einzelwerte sind deshalb wenig belastbar. Die Richtung ist es: Die Lücke zwischen Open-Weight- und Frontier-Modellen ist bei Coding-Benchmarks kleiner als 2024, verschwunden ist sie nicht.
Das Modell ist nicht mehr der einzige Engpass. Das Scaffold entscheidet mit, also die Orchestrierungsschicht, die Kontext, Tools und Planungslogik zusammenhält.
Augment Code hat auf SWE-bench Pro mit demselben Claude-Opus-4.5-Modell vier verschiedene Agent-Harnesses getestet (Zahlen aus Augments eigenem Benchmark-Report): SWE-Agent 45,9 Prozent, Claude Code 49,8 Prozent, Cursor 50,2 Prozent, Auggie 51,8 Prozent. Sechs Prozentpunkte Unterschied, identische Gewichte. Endor Labs misst auf der Agent Security League noch größere Spannweiten: Cursor mit GPT-5.5 erreicht 87,2 Prozent Functional Correctness und 23,5 Prozent Security Correctness. Codex mit GPT-5.5 liegt bei 61,5 Prozent Functional Correctness. Derselbe Modell-Snapshot, derselbe Tag, 25,7 Punkte Unterschied bei Functional Correctness.
Claude Code, Codex, Cursor und OpenHands sind keine Chat-Interfaces. Sie sind Orchestrierungsschichten mit Tool-Calling, Kontext-Management, Planungs-Loops und Sub-Agents. Ein selbst gehostetes GLM-5 auf eigenen GPUs ohne diese Schicht ist kein On-Prem-Coding-Agent. Es ist ein Chatbot mit Coding-Fokus.
Warum echtes On-Prem trotzdem teuer bleibt
Die Hardware-Realität: Acht H100 kosten in der PCIe-Variante 25.000 bis 35.000 Euro pro Karte. Ein 8×H100-System liegt zwischen 250.000 und 420.000 Euro, abhängig von PCIe versus SXM, neu versus generalüberholt, Integrator versus Eigenbau. GMI Cloud veranschlagt für den laufenden Betrieb jährlich 30 bis 40 Prozent der Hardwarekosten.
Im ersten Jahr sieht die Rechnung so aus (100 Entwickler, produktionstauglich):
- Anschaffung 8×H100-System: 250.000–420.000 €
- Strom und Kühlung: 40.000–60.000 €
- Rack-Fläche oder Housing: 20.000–40.000 €
- MLOps/Infra-Personal (0,5–1 FTE): 80.000–120.000 €
- Wartung, Redundanz, Security Review: 30.000–50.000 €
- Modellbetrieb, Monitoring, Updates: 20.000–40.000 €
Gesamtbelastung im ersten Jahr: 440.000–730.000 €. Ab Jahr zwei, bei fünfjähriger Abschreibung der Hardware, liegt der jährliche Aufwand eher bei 240.000–400.000 Euro. Entscheidend ist der Cash-Out im ersten Jahr.
Gleichzeitig läuft Claude Code über Bedrock mit VPC-Isolation ab dem ersten Tag, mit vorhersagbaren Tokenkosten und ohne Kapitalbindung.
On-Premise ist kein technisches Problem mehr. Es ist ein Kosten-Nutzen-Problem. Die Nutzenseite muss die Kostenseite rechtfertigen. Das Gefühl „die Daten bleiben im Haus" reicht dafür nicht.
Was geht, was nicht, was kommt
Claude Code kann über AWS Bedrock mit VPC-Endpunkten laufen. Die AWS Solutions Library dokumentiert Enterprise-Deployment-Patterns mit OIDC-Federation zu Okta, Entra ID, Auth0 oder Cognito, CloudWatch-Metriken und CloudTrail-Logs.
GitHub Copilot CLI unterstützt seit dem 7. April 2026 BYOK und lokale Modelle über OpenAI-kompatible Endpunkte, Azure OpenAI oder lokal laufende Modelle wie Ollama. Mit lokaler Modellkonfiguration und Offline-Modus (z.B. COPILOT_OFFLINE=true) kann die CLI für stark abgeschottete Umgebungen betrieben werden. Die genaue Netzwerkkonfiguration sollte technisch geprüft werden. Wichtig: Die CLI ist nicht dasselbe wie die IDE-Integration. Die IDE-Authentifizierung läuft weiter über github.com.
Cursor bietet seit dem 25. März 2026 Self-Hosted Cloud Agents. Die Architektur: Cursors Agent-Harness übernimmt Inferenz und Planung und sendet dann Tool Calls an Worker zur Ausführung auf Kundeninfrastruktur. Die Ergebnisse gehen für die nächste Inferenz-Runde an Cursor zurück. Code und Tool-Execution bleiben lokal. Welche Control-Plane- und Modellaufrufe weiterhin über Cursor laufen, muss vertraglich und technisch geprüft werden.
Was nicht geht: Viele kleinere Anbieter werben mit „On-Prem", liefern aber de facto ein VPC-Deployment mit Control-Plane beim Anbieter. Keine Täuschung, aber auch kein echtes Air-Gap. Und die besten Agenten-Harnesses sind auf die Trainingsdaten und Tool-Profile bestimmter Frontier-Modelle abgestimmt. OpenHands mit GLM-5 funktioniert, aber nicht mit derselben Zuverlässigkeit wie Claude Code mit Opus.
Was kommt: Die Kommission hat am 3. Juni 2026 den Vorschlag für den Cloud and AI Development Act (CADA) veröffentlicht. Der Entwurf zielt auf Cloud- und KI-Infrastruktur, Rechenzentrumskapazität und einen EU-weiten Bewertungsrahmen für Cloud- und KI-Souveränität, gestützt auf vier Union-Assurance-Level, die den Zugang zu öffentlichen Aufträgen an abgestufte Souveränitätsanforderungen knüpfen. Open-Weight-Modelle holen schneller auf als 2024 erwartet. Wenn der Trend anhält, dürften neue Generationen aus den GLM-, DeepSeek-, Qwen- und Kimi-Familien die Lücke weiter verkleinern. Wer heute für 2027 plant: In zwei Jahren ist „Frontier oder selbst gehostet" weniger eine Qualitätsfrage. Eher eine Frage von Kosten und Kontrolle.
Die richtigen Fragen
Nicht „On-Premise oder nicht". Sondern: Welche Daten verlassen welche Kontrollgrenze? Welcher Anbieter betreibt welche Komponente? Welches Budget rechtfertigt der Anwendungsfall?
Die pragmatische Antwort liegt 2026 für die wenigsten Teams im Air-Gap. Eher in einem VPC-isolierten Hyperscaler-Deployment mit dokumentierter Governance. Echtes Air-Gap ist ein spezialisiertes Werkzeug, kein Standard. Wer es wählt, sollte es aus einem klaren regulatorischen Grund tun. Nicht aus einem diffusen Unbehagen.
Wenn diese Architekturentscheidung strategisch auf Ihr Unternehmen wirkt, lohnt sich ein genauerer Blick. Die Gesamtübersicht zu Coding Agents führt durch die Abwägungen.
Weiterführende Quellen
- BaFin: Orientierungshilfe zu IKT-Risiken beim Einsatz von KI (18. Dezember 2025) · Fokusrisiken 2026
- BSI: C3A Souveränitätskatalog · C5:2026
- EU: Verordnung (EU) 2026/1744, Digital Omnibus, Amtsblatt vom 24. Juli 2026 · CADA-Vorschlag (3. Juni 2026)
- KPMG: Cloud-Monitor 2025 Financial Services (Studie) · Zusammenfassung mit LLM-Quote
- OpenAI: Why we no longer evaluate SWE-bench Verified (23. Februar 2026) · SWE-bench Pro Leaderboard
- AWS: Guidance for Claude Code with Amazon Bedrock · Bedrock Security and Privacy
- GitHub: Copilot CLI BYOK und Offline-Modus
- Cursor: Self-Hosted Cloud Agents
- Augment Code: Auggie tops SWE-Bench Pro
- Endor Labs: GPT-5.5 in Agent Security League
- GMI Cloud: H100 GPU Cost Guide 2026